

HTML Nasıl Çalışır? Living Standard, Document Yapısı ve Parser'ın Hatayı Affetmesi
HTML'in sürümü yok: WHATWG'nin sürekli güncellenen Living Standard'ı esas, bir özelliği kullanıp kullanamayacağını ise Baseline söyler. Bu yazıda minimum geçerli document'ı, element/attribute/void element/content model kavramlarını ve parser'ın hatalı markup'ı nasıl sessizce düzelttiğini Chromium ve WebKit'te gerçek DOM çıktısıyla görüyor, hataları Nu Html Checker ile yakalıyoruz.
Sürüm notu: Bu yazı HTML (HyperText Markup Language) Living Standard'ın ve Baseline'ın Kasım 2026 durumuna göre yazıldı; örnekler Chrome 158, WebKit 27.2 (Playwright 1.65) ve Nu Html Checker 26.11.9 ile denenmiştir.
Önce Tahmin Et
Bookstore'un kitap detay sayfasında fiyatı göstermek için birisi şu satırı yazmış:
<p>Price: <div class="price">42.50 USD</div></p>Tarayıcıda sayfa sorunsuz görünüyor, fiyat yerinde. Soru şu: tarayıcı bu satırdan DOM'a (Document Object Model) kaç tane <p> element'i koyar? Bir mi, iki mi, sıfır mı? Ve .price class'lı div, p'nin içinde mi kalır?
Cevabı tahmin edip bir kenara yaz; yazının ortasında iki ayrı tarayıcı motorunda çıktısını göreceğiz. Bu, serinin ilk yazısı. Seride doğru element'i doğru anlam için seçmeyi konuşacağız, ama önce zemini kurmamız lazım: HTML bugün kim tarafından ve nasıl tanımlanıyor, en küçük geçerli document neye benzer ve tarayıcı yazdığın markup'ı nasıl ağaca çeviriyor. Özellikle son kısım, "tarayıcıda görünüyor, demek ki doğru" alışkanlığının neden tehlikeli olduğunu gösterecek.
"HTML5" Bugün Ne Demek? Living Standard ve W3C–WHATWG Anlaşması
İş ilanlarında hâlâ "HTML5 (HTML'in beşinci nesli) bilgisi" yazıyor, ama HTML5 diye ayrı bir sürüm artık geliştirilmiyor. Kısa tarih şöyle: 2004'te Apple, Mozilla ve Opera, W3C'nin (World Wide Web Consortium) XHTML (Extensible HyperText Markup Language) 2.0 yönünden memnun olmadıkları için WHATWG'yi (Web Hypertext Application Technology Working Group) kurdu ve HTML'i geriye uyumlu biçimde geliştirmeye başladı. Bir süre iki kurum paralel metinler yayımladı; W3C'nin "HTML5" Recommendation'ı 2014'te çıktı. WHATWG ise 2011'de sürüm numarasını bıraktı ve metnine HTML Living Standard dedi: tek bir metin, sürekli güncellenir, altıncı bir sürüm gelmez.
İki paralel metin dönemini 28 Mayıs 2019'da imzalanan W3C–WHATWG mutabakat zaptı (Memorandum of Understanding) bitirdi. Anlaşmaya göre HTML ve DOM standartları WHATWG'de, Living Standard süreciyle geliştiriliyor; W3C ise WHATWG'nin belirli aralıklarla dondurduğu Review Draft'ları kendi süreciyle onaylayıp Recommendation olarak yayımlıyor. Yani bugün "HTML'in kuralı ne?" diye sorduğunda bakacağın adres html.spec.whatwg.org. "HTML5" ise pratikte "modern HTML" anlamına gelen bir etiket olarak yaşıyor; serinin adında da bu anlamda duruyor.
Bunun sana bir pratik etkisi var: "HTML'in hangi sürümünü kullanıyoruz?" sorusunun cevabı yok. Doctype'ta sürüm yazmıyorsun, spec'te sürüm yok. Doğru soru "bu özellik bugün hangi tarayıcılarda çalışıyor?" ve bu sorunun da artık ortak bir cevabı var.
Baseline: "Bunu Kullanabilir miyim?" Sorusunun Cevabı
Sürümsüz bir standartta bir özelliğin spec'e girmesi, kullanabileceğin anlamına gelmez. Örneğin dialog element'inin closedby attribute'u spec'te var; Chrome 134'ten, Firefox 141'den beri çalışıyor, ama Safari'de hâlâ yok. Bunu her özellik için tarayıcı tablolarından okumak yerine W3C'nin WebDX Community Group'u Baseline adında ortak bir etiket tanımladı.
Baseline'ın çekirdek tarayıcı seti Chrome, Edge, Firefox ve Safari; Chrome ve Firefox masaüstü ile Android'de, Safari macOS ile iOS'ta sayılıyor. Bir özellik bu setin hepsinin güncel sürümünde çalışmaya başladığı gün "newly available" olur. O tarihten 30 ay geçince "widely available" olur; bu, eski sürümleri kullanan kullanıcıların çoğunun da güncellendiği varsayımıdır. Henüz bir tarayıcıda eksik olan özellik "limited availability" durumundadır.
Bu serinin her yazısında bir özelliği önerirken Baseline durumunu Kasım 2026 itibarıyla vereceğim. Sen de kendi projende aynı kaynaklara bakabilirsin: MDN (MDN Web Docs) sayfalarının üstündeki Baseline kutusu ve web-features explorer sitesi (web-platform-dx.github.io/web-features-explorer). Örneğin ikinci yazıda kullanacağımız <search> element'i Ekim 2023'te newly available oldu ve Nisan 2026'da widely available'a geçti. Bir ekip olarak "widely available olan her şeyi fallback'siz kullanırız, newly available olanı progressive enhancement ile kullanırız" gibi bir kural koymak, tartışmayı tek cümleye indirir.
Minimum Geçerli Document ve Temel Kavramlar
Her şeyin başladığı yer, Nu Html Checker'dan tek bir uyarı bile almayan en küçük Bookstore sayfası:
<!doctype html>
<html lang="en">
<head>
    <meta charset="utf-8">
    <meta name="viewport" content="width=device-width, initial-scale=1">
    <title>Clean Architecture | Bookstore</title>
</head>
<body>
    <h1>Clean Architecture</h1>
    <p>Robert C. Martin</p>
</body>
</html>
Satır satır gidelim. <!doctype html> bir element değil; tarayıcıya "bu sayfayı standards mode'da işle" der. Büyük/küçük harf fark etmez ve içinde sürüm yoktur; eski HTML 4'teki uzun DTD (Document Type Definition) satırlarının tek görevi kalan kısmı budur. Doctype'ı unutursan tarayıcı sayfayı quirks mode'da işler: CSS'in (Cascading Style Sheets) bazı kuralları 2000'lerin başındaki tarayıcıları taklit edecek şekilde değişir. Doctype'sız bir sayfada Chrome da WebKit de document.compatMode için BackCompat döndürüyor, doctype'lı sayfada CSS1Compat.
lang attribute'u sayfanın dilini söyler. Ekran okuyucu doğru telaffuzu, tarayıcı çeviri önerisini ve text-transform: uppercase gibi dile duyarlı CSS kurallarını buna göre seçer. Türkçe bir sayfada lang="tr" yazmazsan "i" harfinin büyük hâli "I" olur, "İ" değil. Bu örnekte metin İngilizce olduğu için lang="en" yazdım; Bookstore'un Türkçe sayfaları lang="tr" taşır.
<meta charset="utf-8"> karakter kodlamasını bildirir ve dosyanın ilk 1024 byte'ı içinde olmalıdır; viewport meta'sı mobil tarayıcının sayfayı masaüstü genişliğinde render etmesini engeller. İkisinin de ayrıntısı bu serinin head ve meta tag'ler yazısında. <title> ise head'in zorunlu çocuğudur; eksikse Nu Html Checker hata verir.
Bu küçük örnek dört kavramı da gösteriyor. Element, bir start tag, içerik ve end tag'den oluşan yapı taşıdır: <h1>…</h1>. Attribute, element'in start tag'ine yazılan ad–değer çiftidir: lang="en". Void element, içeriği olamayan ve bu yüzden end tag'i de olmayan element'tir; spec'teki liste kısa: area, base, br, col, embed, hr, img, input, link, meta, source, track ve wbr. Content model ise her element'in içine neyin girebileceğini tanımlayan kuraldır. Spec içerikleri kategorilere ayırır: flow content (body'ye girebilen hemen her şey), phrasing content (metin ve metin içi element'ler: a, em, code, span…) gibi. p'nin content model'i phrasing content'tir. Tahmin sorusunun cevabının ipucu tam burada: div phrasing content değil.
Son bir not: <html>, <head>, <body> tag'leri ve li, p, td gibi element'lerin end tag'leri opsiyonel; yazmasan da parser element'leri oluşturur. Okunur kalması için bu serideki örneklerde hepsini açıkça yazacağım.
Parser: Tokenizer'dan DOM'a
Tarayıcı HTML'i bir metin olarak indirir, ama ekranda çizdiği ve JavaScript'in eriştiği şey bir ağaçtır: DOM. Bu çeviriyi HTML parser yapar ve spec onu iki aşamada tanımlar.
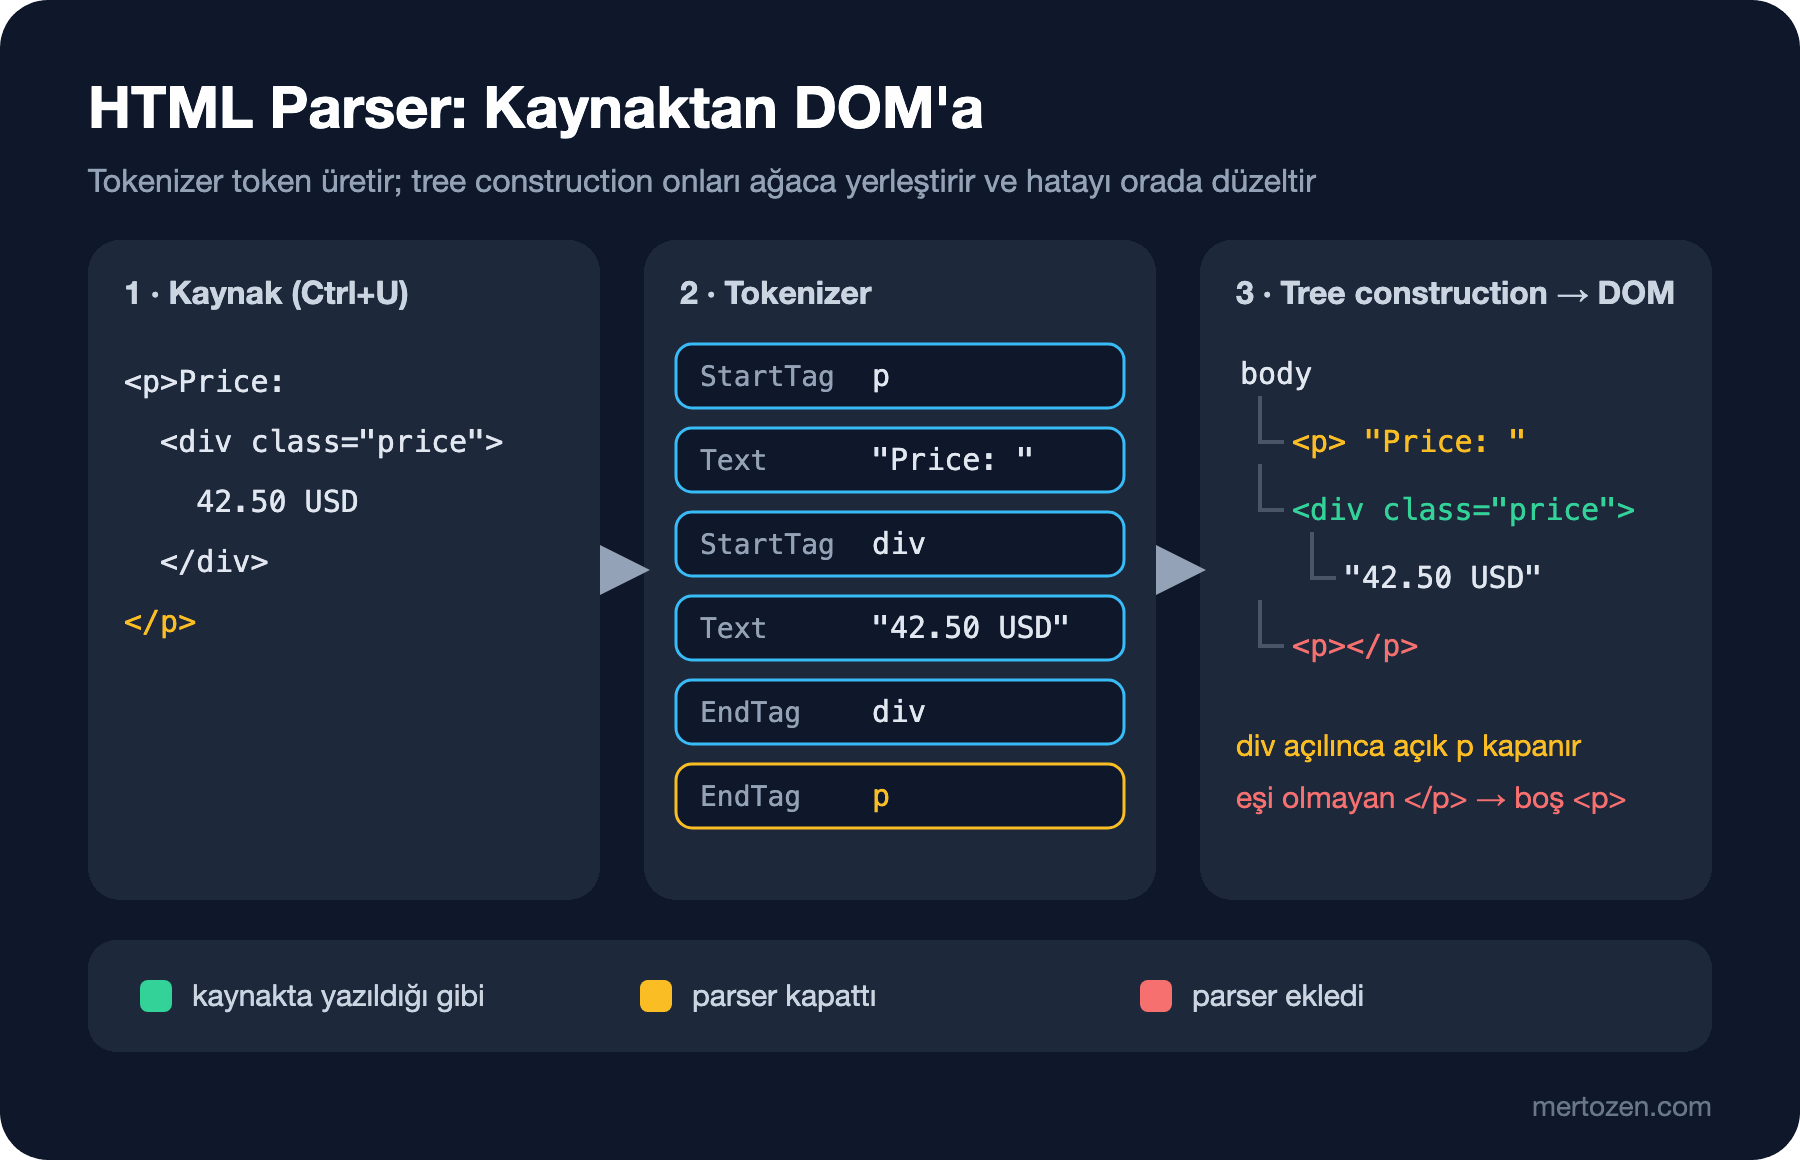
İlk aşama tokenizer. Karakterleri tek tek okur ve bir state machine ile token üretir: start tag (adı ve attribute'larıyla), end tag, karakter, comment, doctype. Tokenizer yapı bilmez; </p> gördüğünde açık bir p olup olmadığını umursamaz, sadece "EndTag p" token'ı üretir.
İkinci aşama tree construction. Gelen her token'ı, o anki insertion mode'a (ör. "in body", "in table") ve açık element'lerin tutulduğu stack'e bakarak ağaca yerleştirir. Hatalı markup'ın düzeltildiği yer burasıdır. Her hata durumu spec'te tek tek tanımlıdır: hangi element kapanır, hangisi yeni oluşturulur, hangisi başka yere taşınır. HTML5 çalışmasının en önemli katkılarından biri de bu oldu: önceden her tarayıcı hatalı markup'ı kendi bildiği gibi düzeltirdi, artık tüm büyük motorlar aynı algoritmayı uyguluyor. Aynı hatalı sayfa Chrome'da ve Safari'de aynı DOM'u üretir. Bu tutarlılık iyi haber, ama ürettikleri DOM'un senin kafandaki ağaç olacağının garantisi değil.
Parser'ın Hatayı Affetmesi: Üç Gerçek Örnek
Tahmin sorusundaki satırı iki hatayla daha birleştirip bir sayfa yaptım. Üçü de gerçek projelerde, özellikle backend'den string birleştirerek ya da bir template'e sonradan satır eklenerek üretilen HTML'de sık görülür:
<!doctype html>
<html lang="en">
<head>
    <meta charset="utf-8">
    <title>Clean Architecture - Bookstore</title>
</head>
<body>
    <h1>Clean Architecture</h1>
    <p>Price: <div class="price">42.50 USD</div></p>
    <table>
        <tr><th>Format</th><th>Stock</th></tr>
        <tr><td>Paperback</td><td>12</td></tr>
        <div class="note">Ships in 2 days</div>
    </table>
    <p><b>Bestseller <i>this week</b> in Software</i></p>
</body>
</html>
Tarayıcının bundan ne ürettiğini görmek için küçük bir Playwright script'i yazdım. Sayfayı Chromium ve WebKit'e yüklüyor, body'nin parse sonrası hâlini ve DOM'daki p sayısını yazdırıyor:
const { chromium, webkit } = require('playwright');
const fs = require('fs');

const source = fs.readFileSync(process.argv[2], 'utf8');

(async () => {
  for (const engine of [chromium, webkit]) {
    const browser = await engine.launch();
    const page = await browser.newPage();
    await page.setContent(source);
    // innerHTML kaynağı değil, parse edilmiş DOM'u serialize eder
    const dom = await page.evaluate(() => document.body.innerHTML);
    const pCount = await page.locator('p').count();
    console.log(`--- ${engine.name()} ${browser.version()} | p elements: ${pCount}`);
    dom.split('\n').map(l => l.trim()).filter(Boolean).forEach(l => console.log(l));
    await browser.close();
  }
})();
> node dom-diff.js book.html
--- chromium 158.0.8127.18 | p elements: 3
<h1>Clean Architecture</h1>
<p>Price: </p><div class="price">42.50 USD</div><p></p>
<div class="note">Ships in 2 days</div><table>
<tbody><tr><th>Format</th><th>Stock</th></tr>
<tr><td>Paperback</td><td>12</td></tr>
</tbody></table>
<p><b>Bestseller <i>this week</i></b><i> in Software</i></p>
--- webkit 27.2 | p elements: 3
<h1>Clean Architecture</h1>
<p>Price: </p><div class="price">42.50 USD</div><p></p>
<div class="note">Ships in 2 days</div><table>
<tbody><tr><th>Format</th><th>Stock</th></tr>
<tr><td>Paperback</td><td>12</td></tr>
</tbody></table>
<p><b>Bestseller <i>this week</i></b><i> in Software</i></p>Tahmin sorusunun cevabı: fiyat satırından iki p çıkıyor ve ikisi de div'i içermiyor. Parser <div> start tag'ini gördüğünde açık bir p olduğunu fark ediyor ve div phrasing content olmadığı için önce p'yi kapatıyor. div kardeş olarak ekleniyor. Sonra gelen </p>'nin kapatacağı açık bir p kalmamış; spec bu durumda boş bir <p></p> oluşturmayı söylüyor. Sayfada bir satırlık boşluk görürsen ve nereden geldiğini bulamazsan, aradığın şey büyük ihtimalle bu boş paragraftır. Bir de p > .price selector'ü yazdıysan hiçbir şeyi seçmez.
İkinci örnek tabloda. Table'ın içinde yalnız caption, colgroup, thead, tbody, tfoot ve tr gibi table element'leri durabilir. Parser "in table" insertion mode'dayken bir div görünce onu foster parenting denen kuralla tablonun hemen önüne taşıyor. Sen notun tablonun altında görünmesini beklerken o tablonun üstünde çıkıyor. Bir de yazmadığın bir tbody beliriyor: parser, table'ın içine doğrudan yazılan tr'leri her zaman bir table section'ın içine koyar. Bu ikinci davranışı bilmeyen birinin yazdığı table > tr selector'ü de boş döner.
Üçüncü örnek iç içe geçmiş formatting element'leri: b içinde açılan i, b'den sonra kapanıyor. Spec bu durum için adoption agency algoritmasını tanımlıyor: i'yi b'nin sonunda kapatıp b'nin dışında yeni bir i açıyor. Görüntü neredeyse aynı, ama DOM'da artık iki ayrı i var; bir CSS kuralının ya da test selector'ünün "yarım" çalışmasının sebebi çoğu zaman böyle bir farktır.
Kaynak mı DOM mu? DevTools'ta Farkı Görmek
Bu farkı script yazmadan da görebilirsin. Windows'ta Chrome ya da Edge'de sayfadayken Ctrl+U kaynak görünümünü açar: sunucunun gönderdiği metin, olduğu gibi. F12 (DevTools kısayolu) ile açılan DevTools'un Elements paneli ise DOM'u gösterir: parser'ın düzelttiği ve JavaScript'in o ana kadar değiştirdiği ağaç. Yukarıdaki sayfada Elements panelinde div.note'u tablonun üstünde, fiyat satırının altında da boş bir <p></p> görürsün. Kaynak görünümü yalnız syntax'ı renklendirir; parse hatalarını sana göstermez, bu iş validator'ın.
Elements panelinin ayrıntıları Browser DevTools serisinin ilk yazısında. Kural basit: "sayfada ne var?" sorusunun cevabı Elements panelinde, "sunucu ne gönderdi?" sorusunun cevabı kaynakta. Bir selector ya da test locator'ı tutmuyorsa ikisini yan yana koy.
Angular ya da başka bir framework kullanıyorsan bu fark iki katına çıkar: framework DOM'u kendisi kurar, ama tarayıcının kuralları değişmez. Bir template'te p içine div koyduğunda Angular'ın derleyicisi bunu kabul edebilir, ama sunucu tarafında render edilmiş (SSR, Server-Side Rendering) HTML tarayıcıda parse edildiğinde yukarıdaki düzeltme yine olur. Bu durumda hydration, framework'ün beklediği DOM'u bulamaz; Angular'ın hydration rehberi p içinde div, tbody'siz table ve iç içe a örnekleri için DOM mismatch hatası verileceğini söyler ve tbody'yi her zaman açıkça yazmayı önerir. Framework'lerde ortaya çıkan HTML'i serinin son yazılarından birinde ayrıca ele alacağız.
Nu Html Checker ile Doğrulama
Parser hatayı affediyor diye hata ortadan kalkmıyor; sadece sessizleşiyor. Onu sesli hâle getiren araç, W3C'nin validator.w3.org/nu adresinde de çalışan Nu Html Checker (vnu). Aynı sayfayı ona verdiğimde gelen çıktı:
:9.49-9.52: error: No “p” element in scope but a “p” end tag seen.
:12.47-13.26: error: Start tag “div” seen in “table”.
:12.47-13.26: error fatal: Cannot recover after last error. Any further errors will be ignored.
İlk satır fiyat satırındaki eşi olmayan </p>'yi satır ve sütun numarasıyla gösteriyor. İkincisi tablodaki div'i buluyor. Üçüncüsü önemli bir detay: checker tablodaki bu hatadan sonra durdu, bu yüzden b/i hatasını raporlamadı. Tablodaki notu bir <tr><td colspan="2"> satırına çevirip tekrar çalıştırınca sıradaki hata da çıkıyor:
:9.49-9.52: error: No “p” element in scope but a “p” end tag seen.
:15.34-15.37: error: End tag “b” violates nesting rules.
Yani validator'ı bir kez çalıştırıp "üç hata varmış" deme; hataları düzeltip sıfıra inene kadar tekrarla.
Validator'ın yakaladığı bir başka yaygın hata, JSX (React'in JavaScript içinde HTML benzeri markup yazdıran syntax uzantısı) ya da Angular template alışkanlığıyla düz HTML'e yazılan self-closing tag:
<!doctype html>
<html lang="en">
<title>x</title>
<img src="cover.jpg" alt="Cover" />
<div class="spacer" />
<p>Stock: 12</p>
:4.1-4.35: info: Trailing slash on void elements has no effect and interacts badly with unquoted attribute values.
:5.1-5.22: error: Self-closing syntax (“/>”) used on a non-void HTML element. Ignoring the slash and treating as a start tag.
:6.17-6.17: error: End of file seen and there were open elements.
:5.1-5.22: error: Unclosed element “div”.Void element'teki / zararsız; parser onu yok sayıyor ve checker yalnız bilgi notu düşüyor. Ama div void değil: parser /'ı yok sayıp div'i açık bırakıyor ve sayfanın geri kalanı, burada <p>Stock: 12</p>, bu div'in içine giriyor. Chromium'un bu parçadan ürettiği DOM'da p gerçekten div.spacer'ın çocuğu.
Tek bir dosyayı web arayüzüne yapıştırmak yerine build çıktısının tamamını kontrol etmek istersen checker'ın resmi Docker image'ı işini görür. Windows'ta PowerShell'de, Docker Desktop açıkken:
docker run --rm -v "${PWD}/dist:/site" ghcr.io/validator/validator:latest vnu --errors-only /site"file:/site/book.html":9.49-9.52: error: No “p” element in scope but a “p” end tag seen.
"file:/site/book.html":12.47-13.26: error: Start tag “div” seen in “table”.
"file:/site/book.html":12.47-13.26: error fatal: Cannot recover after last error. Any further errors will be ignored.Komut, hata bulduğunda 1 exit code'u ile çıkıyor; bu da onu bir CI (Continuous Integration) adımına koymayı kolaylaştırıyor. --errors-only bilgi notlarını ve uyarıları gizler. Docker kullanmıyorsan aynı checker vnu.jar olarak da dağıtılıyor ve Java ile çalışıyor.
Üretimde Dikkat
Validator'ı kaynak dosyalarına değil, tarayıcıya giden HTML'e çalıştır. Bir Razor view ya da Angular template'i doğrudan validator'a vermek anlamsızdır, çünkü @if blokları, Tag Helper'lar ve component selector'leri henüz HTML'e dönüşmemiştir. Doğru hedef, uygulamanın ürettiği çıktı: statik siteyse build klasörü, server-side render ediyorsan ayağa kaldırılmış uygulamadan birkaç kritik sayfanın HTML'ini çekip checker'a vermek. Bookstore için bu liste ana sayfa, katalog, kitap detay, arama sonucu ve checkout.
İkinci nokta: checker'ın her mesajı aynı ağırlıkta değil. error satırları spec ihlalidir ve çoğu, yukarıda gördüğün gibi DOM'u senin beklemediğin bir yapıya çevirir. info warning satırları (ör. eksik lang) tavsiyedir. CI'da önce yalnız error'larda build'i kırmak, warning'leri raporlayıp zamanla temizlemek pratik bir başlangıçtır. Büyük bir uygulamada ilk çalıştırma yüzlerce hata çıkarabilir; o anki sayıyı kaydedip "bu sayı artmasın" kuralıyla başlamak daha gerçekçidir.
Üçüncüsü, parse hatalarının çoğu HTML'i string birleştirerek üreten koddan gelir: CMS'ten (Content Management System) gelen zengin metin, backend'de StringBuilder ile kurulan bir parça, innerHTML'e basılan bir string. Bu kaynaklar hem yapı bozukluğu hem güvenlik açığı üretir; güvenlik tarafı Frontend Güvenliği serisinde.
Sık Düşülen Tuzaklar
Birincisi, "tarayıcıda görünüyor, demek ki doğru" demek. Bu yazının bütün örnekleri tarayıcıda düzgün görünüyordu. Görünüm sağlam olsa bile DOM farklı; ve CSS selector'leri, testler, ekran okuyucular ve arama motorları görünüme değil DOM'a bakar.
İkincisi, doctype'ı unutmak. Doctype'ın eksik olduğu tek bir layout dosyası, o layout'u kullanan bütün sayfaları quirks mode'a sokar; belirtisi yalnız bazı sayfalarda tutmayan box model hesaplarıdır.
Üçüncüsü, p'yi genel amaçlı bir kutu gibi kullanmak. p paragraf demektir ve içine yalnız phrasing content girer. İçine bir div, ul, table ya da başka bir p koyduğun anda parser onu bölüyor.
Dördüncüsü, JSX ve framework template alışkanlıklarını düz HTML'e taşımak: <div />, <span /> ya da custom element'lerde self-closing yazmak. HTML parser için bunlar açık kalan element'lerdir.
Küçük Bir Deneme
★☆☆ Yazıdaki book.html'i kendi makinende bir dosyaya kaydet, Chrome'da aç ve Ctrl+U ile kaynağı, F12 ile Elements panelini yan yana koy. Parser'ın taşıdığı, kapattığı ve eklediği üç yeri Elements panelinde bul; sonra dosyanın en üstündeki doctype'ı silip DevTools Console'da document.compatMode'a bak.
★★☆ Aynı sayfayı Nu Html Checker'a ver ve hata sıfıra inene kadar düzelt. Fiyatı p içinde tutmak istiyorsan div yerine hangi element'i kullanırsın? Notu tablonun içinde tutmak istiyorsan hangi table element'i doğru yer olur?
★★★ Çalıştığın projenin build çıktısına ya da birkaç kritik sayfasının render edilmiş HTML'ine Docker'daki vnu --errors-only komutunu çalıştır. Hataları türüne göre grupla ve en sık çıkan üç hatanın hangi template'ten ya da hangi koddan geldiğini bul. CI'a eklemek için "hata sayısı artmasın" kuralını nasıl uygulayacağını düşün.
Bir sonraki yazıda bu kemik yapının üzerine anlamı koyuyoruz: Bookstore'un kitap detay sayfasını "div soup"tan çıkarıp header, nav, main, article, section, aside, footer ve search ile yeniden kuracak ve her element'in accessibility tree'de hangi landmark'a dönüştüğünü göreceğiz.