

Faceted Navigation, Pagination ve Infinite Scroll: Katalog Filtrelerini Crawl Budget'ı Harcamadan Sunmak
Index'lenmesi gerekmeyen filtre URL'leri robots.txt ile crawl dışında tutulur; index'lenecek filtreler tek yazımla, sabit sırada ve & ile kurulur, sonuçsuz kombinasyon o URL'de 404 döner ve her sayfa kendi canonical'ını taşır. Bookstore kataloğunda filtreleri normalize eden ASP.NET Core kodunu, gerçek link'li pagination'ı, crawl edilebilir "daha fazla yükle"yi ve Angular SSR'daki karşılığını kuruyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (ASP.NET Core 10.0.15) ve Angular 22.2 (@angular/ssr 22.2.7, Node.js 24) ile derlenip denenmiştir; kurallar Google'ın faceted navigation dokümanının (son güncelleme 18 Aralık 2025), e-ticaret pagination dokümanının ve lazy-loading dokümanının (ikisi de 10 Aralık 2025) Kasım 2026'da okunan hâli esas alınarak anlatılmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) bilim kurgu kategorisinde 30 kitap var. Kullanıcı listeyi dile (Türkçe, İngilizce), baskı türüne (ciltli, karton kapak, e-kitap) göre filtreleyebiliyor, başlığa, fiyata ya da yıla göre sıralayabiliyor; sayfa başına 12 kitap gösteriliyor. Ekipte üç öneri dolaşıyor: "Bütün filtreli sayfaların canonical'ı birinci sayfa olsun, kopya içerik sorunu biter", "Sonuç dönmeyen filtrelerde kullanıcıyı ana sayfaya yönlendirelim" ve "Sayfalar arası ilişkiyi rel=next ve rel=prev ile bildirelim".
Tek bir kategori için kaç farklı URL üretilebilir? Üç önerinin hangisi Google'ın bugünkü dokümanıyla uyuşuyor?
Kaba bir hesap: dil için üç durum (yok, Türkçe, İngilizce), baskı türü için dört (yok ve üç tür), sıralama için üç seçenek; tek bir kategoride 36 kombinasyon, sayfalarla birlikte yüzü aşıyor. Parametrelerin farklı sırada yazılması, aynı parametrenin iki kez eklenmesi ve var olmayan sayfa numaraları da sayılınca sınır yok. Serinin on birinci yazısındaki log analizinde gördüğümüz "Googlebot'un isteklerinin çoğu aynı listenin varyasyonlarına gidiyor" tablosunun kaynağı tam olarak bu.
Filtre URL'leri Neden Sorun?
Google'ın faceted navigation dokümanı sorunu iki başlıkta topluyor. Birincisi aşırı crawl: filtre URL'leri crawler'a yeni görünüyor ve crawler bir URL'in işe yarayıp yaramadığını onu crawl etmeden bilemiyor; bu yüzden işe yaramadıklarını anlayana kadar çok sayıda filtre URL'ine girmiş oluyor. İkincisi yeni içeriğin geç keşfi: crawl zamanı gereksiz URL'lere harcandıkça yeni ve faydalı URL'lere daha az zaman kalıyor.
Doküman iki yol tarif ediyor. Filtre URL'lerinin index'lenmesine ihtiyacın yoksa onları crawl'a kapat. İhtiyacın varsa, URL'leri dokümandaki kurallara göre kur ve bunun sunucu kaynağı ve keşif hızı açısından bir bedeli olduğunu kabul et. Bookstore iki yolu birlikte kullanıyor: tür ve tür + dil sayfaları index'lenecek, çünkü "Türkçe bilim kurgu kitapları" gerçekten aranan bir şey; baskı türü ve sıralama yalnız kullanıcı için.
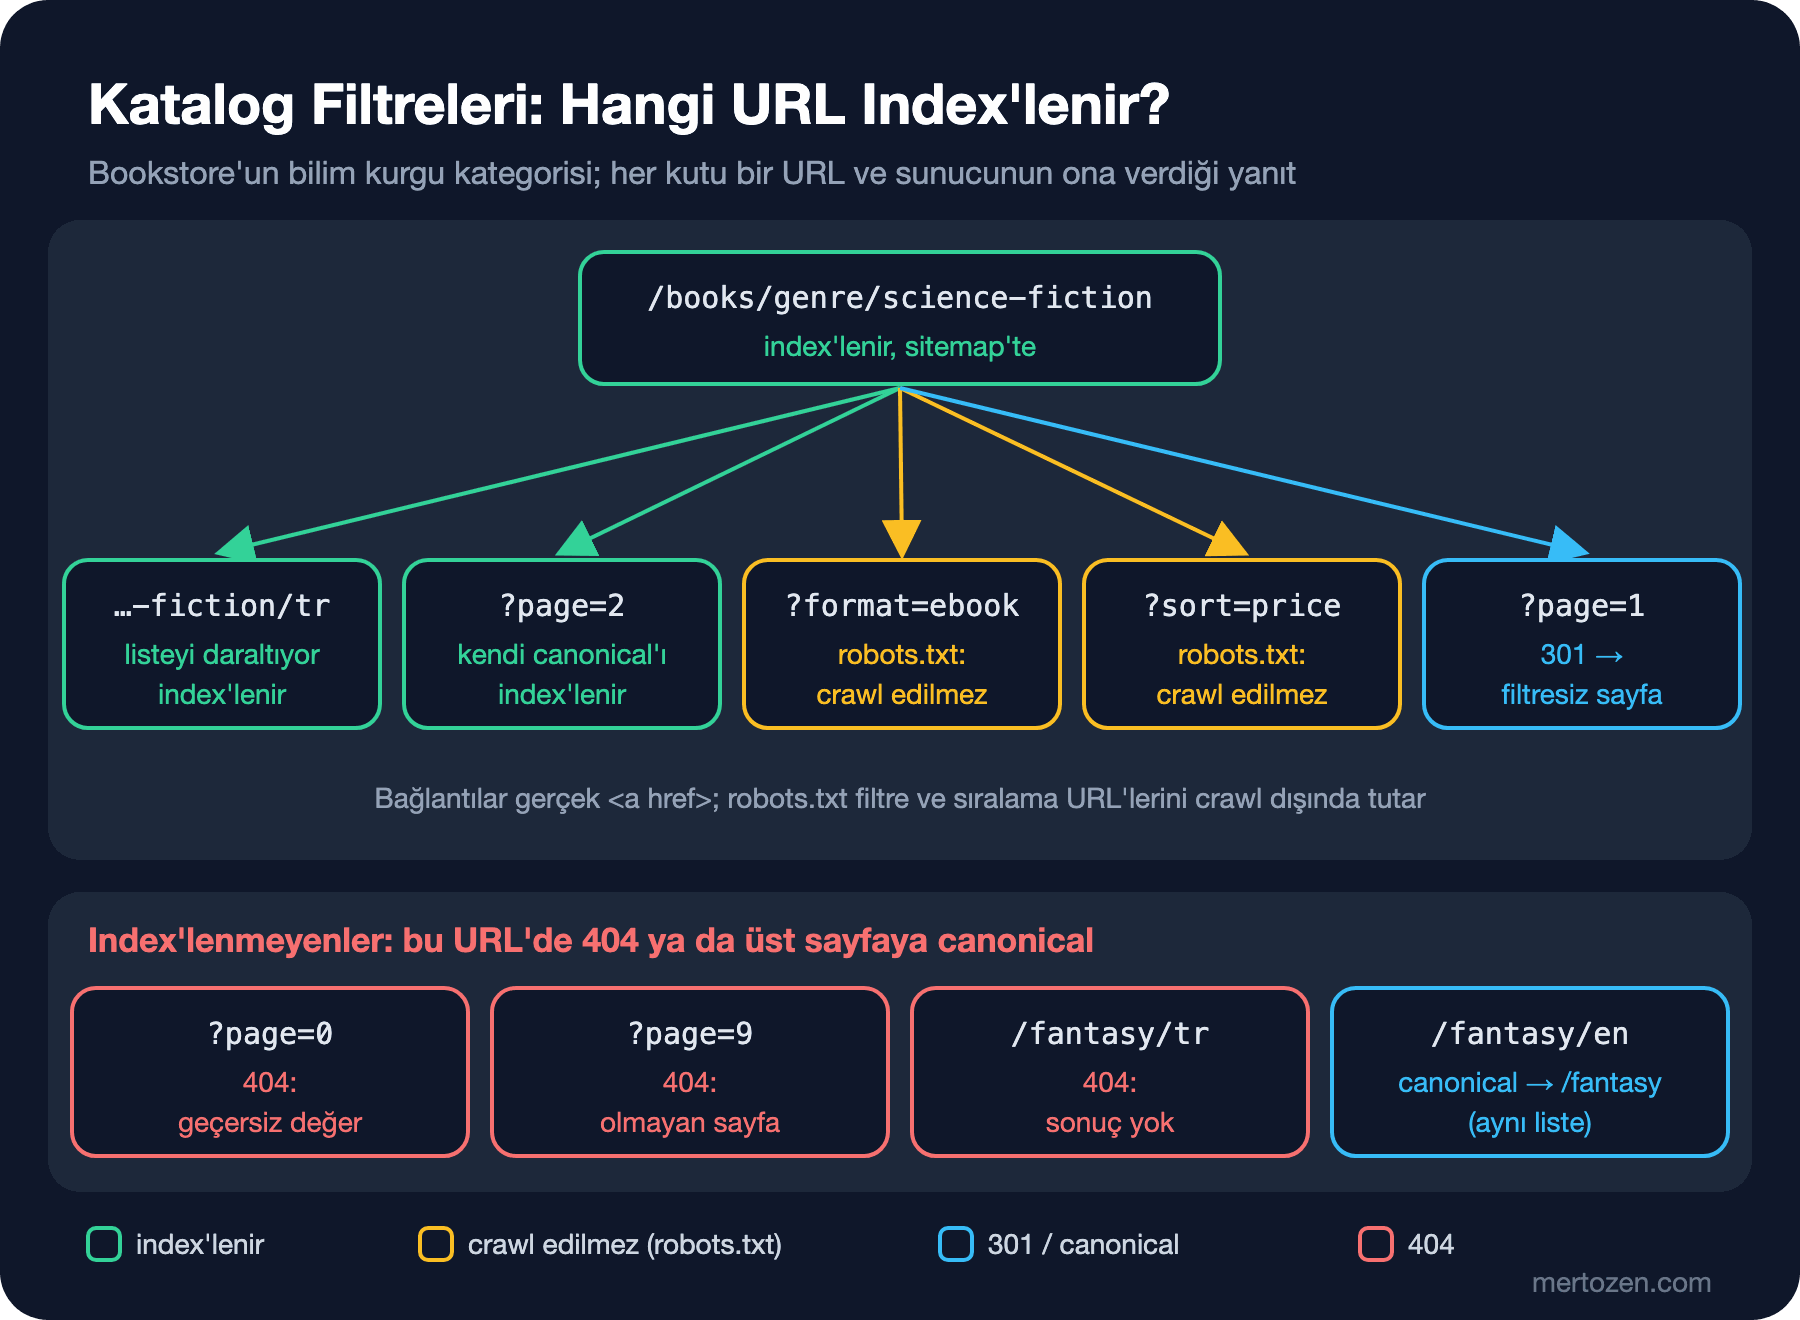
| Filtre | URL biçimi | Index | Mekanizma |
|---|---|---|---|
| Tür | /books/genre/science-fiction | Evet | Sitemap'te, kendi canonical'ı |
| Tür + dil | /books/genre/science-fiction/tr | Evet, listeyi daraltıyorsa | Path'te sabit sıra |
| Sayfa | ?page=2 | Evet | Kendi canonical'ı, sıralı link'ler |
| Baskı türü, sıralama | ?format=ebook, ?sort=price | Hayır | robots.txt Disallow |
Crawl'a Kapatmak: robots.txt, Fragment, canonical, nofollow
Index'lenmesi gerekmeyen filtreler için doküman iki etkili yol gösteriyor. Birincisi robots.txt ile filtre parametrelerini engellemek; dokümana göre filtrelenmiş listeleri crawl ettirmenin çoğu zaman makul bir sebebi yok, tek tek ürün sayfalarına ve filtresiz bir liste sayfasına izin vermek yetiyor. İkincisi filtreleri URL fragment'ine (#format=ebook) koymak; Google fragment'leri genel olarak crawl ve index'te desteklemediği için bu filtrelerin crawl'a hiçbir etkisi olmuyor. Bookstore birinci yolu seçti, çünkü filtreli sayfaların sunucuda render edilmesi ve paylaşılabilir olması isteniyor:
// filtre ve sıralama URL'leri crawl edilmez; tür ve sayfa URL'leri serbest
app.MapGet("/robots.txt", () => Results.Text("""
    User-agent: *
    Disallow: /*?*format=
    Disallow: /*?*sort=

    Sitemap: https://bookstore.example/sitemap.xml

    """, "text/plain; charset=utf-8"));
/*?*format= kuralı, query string'in herhangi bir yerinde format= geçen bütün URL'leri kapsıyor; ?page=2 gibi yalnız sayfa taşıyan URL'lere dokunmuyor. Dokümanın saydığı diğer iki araç, rel="canonical" ve rel="nofollow", uzun vadede daha az etkili. Filtreli sayfadan filtresiz sayfaya verilen canonical zamanla filtreli URL'lerin crawl'ını azaltabiliyor. nofollow'un işe yaraması için ise o URL'e işaret eden her link'te bulunması gerekiyor; tek bir unutulmuş link yetiyor. Bir de serinin üçüncü yazısındaki çelişki burada da geçerli: robots.txt'nin engellediği bir sayfadaki noindex ya da canonical'ı Google hiç göremez. Bookstore'un filtreli sayfalarında canonical yine filtresiz türü gösteriyor, ama bu yalnız robots.txt'ye uymayan crawler'lar için.
Index'lenecek Filtreler: Tek Yazım, Sabit Sıra
Index'lenmesini istediğin filtre URL'leri için doküman üç kural koyuyor: parametreleri endüstri standardı & ile ayır (virgül, noktalı virgül ya da köşeli parantez crawler'ın ayırıcı olarak tanıyacağı karakterler değil); filtreleri path'e koyuyorsan mantıksal sırası hep aynı kalsın ve aynı filtre iki kez bulunamasın; sonuçsuz kombinasyonda 404 dön.
Bookstore'da index'lenen filtrelerin sırasını route kendisi sabitliyor: /books/genre/{genre}/{language?}. Tür önce, dil sonra; /books/genre/science-fiction/tr/tr gibi tekrar eden bir segment hiçbir route'a uymadığı için 404. Query'deki filtreler için tek bir CatalogQuery var: isteği doğruluyor, varsayılanları atıyor ve URL'in tek doğru yazımını üretiyor:
// null: geçersiz istek (404). Normalized: URL'nin tek doğru yazımı; istekle farklıysa 301
public static (CatalogQuery? Query, string? Normalized) Parse(string genre, string? language, IQueryCollection query)
{
    if (!BookCatalog.Genres.Any(g => g.Slug == genre) || (language is not null && !Languages.Contains(language)))
        return (null, null);

    // aynı filtre iki kez (?format=ebook&format=ebook) ya da anlamsız değer: 404, redirect değil
    if (query.Any(p => p.Value.Count > 1))
        return (null, null);
    // ... format, sort ve page aynı şekilde doğrulanır

    CatalogQuery result = new(genre, language, format, sort, page);
    // varsayılan değerler (?page=1, ?sort=title) atılır, parametre sırası sabitlenir
    string normalized = result.ToUrl();
    return (result, BuildRequested(genre, language, query) == normalized ? null : normalized);
}

// parametreler her zaman aynı sırada ve & ile: format, sort, page
public string ToUrl(string prefix = "")
{
    List<string> parts = [];
    if (Format is BookFormat format) parts.Add($"format={format.ToString().ToLowerInvariant()}");
    if (Sort != "title") parts.Add($"sort={Sort}");
    if (Page > 1) parts.Add($"page={Page}");
    string path = Language is null ? $"{prefix}/books/genre/{Genre}" : $"{prefix}/books/genre/{Genre}/{Language}";
    return parts.Count == 0 ? path : $"{path}?{string.Join('&', parts)}";
}
Sayfadaki bütün filtre ve sayfa link'leri de ToUrl ile üretiliyor; site kendi link'lerinde hep aynı yazımı kullandığı için başka bir yazımla gelen istek ancak dışarıdan gelebilir ve 301 ile tek adrese iniyor. Takip parametreleri (utm_source gibi) bu karşılaştırmaya girmiyor; onları serinin beşinci yazısındaki canonical zaten atıyor.
Sonuçsuz Kombinasyon: O URL'de 404
Dokümanın üçüncü kuralı açılıştaki ikinci öneriyi doğrudan reddediyor: filtre kombinasyonu sonuç döndürmüyorsa kullanıcı da crawler da o URL'de, doğru status code ile bir "bulunamadı" yanıtı almalı. Ortak bir hata sayfasına redirect etmek yerine 404 aynı URL'de verilmeli. Tekrar eden ya da anlamsız filtreler ve var olmayan sayfa numaraları için de aynısı geçerli.
Sıralama burada önemli. İlk taslakta 301 kontrolü sonuç kontrolünden önceydi: ?page=2&format=ebook isteği önce ?format=ebook&page=2'ye 301 alıyordu, hedef ise 404 dönüyordu, çünkü on e-kitap tek sayfaya sığıyor. Bir redirect'in sonunda 404 bulmak hem bir hop israfı hem de dokümanın istediği "hata bulunduğu URL'de" kuralına aykırı. Handler'da önce sonuç kontrolü yapılıyor:
(CatalogQuery? query, string? normalized) = CatalogQuery.Parse(genre, language, Request.Query);
if (query is null)
    return NotFound();

Query = query;
List<Book> all = [.. Query.Apply(catalog.Books)];
TotalPages = (int)Math.Ceiling(all.Count / (double)CatalogQuery.PageSize);
// sonuçsuz kombinasyon ve var olmayan sayfa: o URL'de 404, "bulunamadı" sayfasına redirect değil
if (all.Count == 0 || Query.Page > TotalPages)
    return NotFound();
// sonuç kontrolünden sonra: 301'in hedefi hiçbir zaman 404 olmasın
if (normalized is not null)
    return RedirectPermanent(Prefix + normalized);
$ B=http://127.0.0.1:52213
$ while read -r u; do printf "%-55s %s %s\n" "$u" "$(curl -s -o /dev/null -w '%{http_code}' "$B$u")" "$(curl -sI "$B$u" | grep -i '^location' | tr -d '\r')"; done < urls.txt
/books/genre/science-fiction?page=2 200
/books/genre/science-fiction?page=1 301 Location: /books/genre/science-fiction
/books/genre/science-fiction?sort=year&format=ebook 301 Location: /books/genre/science-fiction?format=ebook&sort=year
/books/genre/science-fiction?page=2&format=ebook 404
/books/genre/science-fiction?page=9 404
/books/genre/science-fiction?format=ebook&format=ebook 404
/books/genre/fantasy/tr 404
/books/genre/science-fiction/tr/tr 404urls.txt ilk sütundaki sekiz URL'i taşıyor. Aynı tablo daha geniş hâliyle CatalogFacetTests'te bir Theory olarak duruyor: 14 URL'in her biri için beklenen status ve Location.
Bir ince nokta daha var: listeyi daraltmayan filtre. Bookstore'un fantastik kitaplarının hepsi İngilizce; /books/genre/fantasy/en sonuç dönüyor, ama /books/genre/fantasy ile birebir aynı listeyi gösteriyor. Bu sayfa 404 değil, ama ayrı bir sayfa olarak da index'lenmemeli: canonical'ı üst türe veriliyor ve sitemap'e girmiyor. Tür sitemap'inin ürettiği liste:
$ curl -s http://127.0.0.1:52213/sitemaps/genres.xml | xmllint --format - | grep "<loc>" | grep -v "/en/books"
    <loc>https://bookstore.example/books/genre/science-fiction</loc>
    <loc>https://bookstore.example/books/genre/science-fiction/tr</loc>
    <loc>https://bookstore.example/books/genre/science-fiction/en</loc>
    <loc>https://bookstore.example/books/genre/fantasy</loc>
    <loc>https://bookstore.example/books/genre/classics</loc>
    <loc>https://bookstore.example/books/genre/classics/tr</loc>
    <loc>https://bookstore.example/books/genre/classics/en</loc>
Pagination: Her Sayfa Kendi URL'i
Google'ın pagination dokümanı üç kural sayıyor. Sayfaları sırayla link'le: her sayfadan bir sonrakine <a href> ile link ver; ayrıca bütün sayfalardan birinci sayfaya link vermek, Google'a birinci sayfanın daha iyi bir giriş sayfası olabileceği ipucunu veriyor. URL'leri doğru kullan: her sayfanın kendine özgü bir URL'i olsun (?page=n gibi), birinci sayfayı bütün serinin canonical'ı yapma, her sayfaya kendi canonical'ını ver ve sayfa numarası için fragment kullanma; Google #'ten sonrasını yok saydığı için yalnız fragment'i farklı olan bir sonraki sayfa link'ini izlemeyebilir. Filtreli ve farklı sıralı listelerin index'lenmesinden kaçın: noindex ya da robots.txt ile.
Açılıştaki iki öneri burada düşüyor. Bütün sayfaları birinci sayfaya canonical'lamak, ikinci ve sonraki sayfalardaki kitapların keşfini zayıflatıyor. rel="next" ve rel="prev" ise dokümana göre Google'ın artık kullanmadığı işaretler; başka arama motorları kullanabilir, Google için bir anlamı yok. Bir rahatlık da var: sayfalı bir dizideki sayfalar aynı title ve description'ı taşıyabiliyor, Google bu sayfaları dizi olarak tanımaya çalışıyor.
Bookstore'un sayfa navigasyonu, ToUrl'den gelen gerçek link'lerden oluşuyor:
<nav aria-label="@(tr ? "Sayfalar" : "Pages")">
    @if (Model.Query.Page > 1)
    {
        <a href="@Model.Query.WithPage(1).ToUrl(p)">@(tr ? "İlk sayfa" : "First page")</a>
        <a href="@Model.Query.WithPage(Model.Query.Page - 1).ToUrl(p)">@(tr ? "Önceki" : "Previous")</a>
    }
    @for (int i = 1; i <= Model.TotalPages; i++)
    {
        @if (i == Model.Query.Page)
        {
            <span aria-current="page">@i</span>
        }
        else
        {
            <a href="@Model.Query.WithPage(i).ToUrl(p)">@i</a>
        }
    }
    @if (Model.Query.Page < Model.TotalPages)
    {
        <a href="@Model.Query.WithPage(Model.Query.Page + 1).ToUrl(p)" data-load-more>@(tr ? "Sonraki" : "Next")</a>
    }
</nav>
$ curl -s "http://127.0.0.1:52213/books/genre/science-fiction?page=2" | grep -E "canonical|<nav|href=\"/books/genre|aria-current|</nav>"
<link rel="canonical" href="https://bookstore.example/books/genre/science-fiction?page=2">
<nav aria-label="Sayfalar">
<a href="/books/genre/science-fiction">İlk sayfa</a>
<a href="/books/genre/science-fiction">Önceki</a>
<a href="/books/genre/science-fiction">1</a>
<span aria-current="page">2</span>
<a href="/books/genre/science-fiction?page=3">3</a>
<a href="/books/genre/science-fiction?page=3" data-load-more>Sonraki</a>
</nav>Load More ve Infinite Scroll
Pagination dokümanı üç arayüz desenini karşılaştırıyor: sayfalama, "daha fazla yükle" butonu ve infinite scroll. Hangisini seçersen seç kural aynı: Google genellikle <a> element'lerinin href'indeki URL'leri crawl ediyor, butonlara tıklamıyor ve kullanıcı hareketi gerektiren JavaScript fonksiyonlarını genellikle tetiklemiyor. Bir "daha fazla yükle" butonu yalnız JavaScript ile çalışıyorsa, Google için ikinci sayfa yok.
Lazy-loading dokümanı infinite scroll için crawl edilebilir bir karşılık tarif ediyor: her parçanın kalıcı ve benzersiz bir URL'i olsun; o URL her açılışta aynı içeriği göstersin, bu yüzden ?date=yesterday gibi göreli değerler yerine mutlak sayfa numaraları kullan; parçalara sırayla link ver; ve kullanıcı scroll ettikçe yeni parça ekranın ana içeriği olduğunda gösterilen URL'i History API ile güncelle. Bookstore'da "Sonraki" link'i bunu sağlıyor: JavaScript yoksa normal bir sayfa geçişi, varsa aynı sayfada "daha fazla yükle":
// "Sonraki" link'i JavaScript varsa "daha fazla yükle" gibi çalışır; yoksa normal sayfa geçişidir.
// Crawler link'i izler (?page=n), kullanıcı aynı sayfada kalır ve adres çubuğu güncellenir.
document.addEventListener('click', async (event) => {
  const link = event.target.closest('a[data-load-more]');
  if (!link) return;
  event.preventDefault();
  const html = await (await fetch(link.href)).text();
  const next = new DOMParser().parseFromString(html, 'text/html');
  document.querySelector('main ul').append(...next.querySelectorAll('main ul > li'));
  document.querySelector('main nav').replaceWith(next.querySelector('main nav'));
  history.replaceState(null, '', link.href); // yenilenen ya da paylaşılan adres doğru sayfayı açar
});
Script ikinci sayfanın HTML'ini istiyor, kitapları mevcut listeye ekliyor ve navigasyonu ikinci sayfanınkiyle değiştiriyor; böylece bir sonraki tıklama üçüncü sayfaya gidiyor. Crawler'ın gördüğü ise sadece bir <a href="?page=3">.
Angular SSR'da Aynı Kurallar
Bookstore'un Angular istemcisinde katalog sayfası sunucuda render ediliyor (RenderMode.Server); veriyi aynı kuralları uygulayan ASP.NET Core API'sinden alıyor. Query'nin normalize edilmesi bir route guard'ında:
// ?page=1 ya da farklı sıralı parametre: tek yazıma kalıcı redirect
export const catalogQueryGuard: CanActivateFn = async (route, state) => {
  // inject() yalnız ilk await'ten önce çalışır
  const http = inject(HttpClient);
  const api = inject(API_BASE);
  const router = inject(Router);
  const responseInit = inject(RESPONSE_INIT, { optional: true });

  const result = normalizeCatalogQuery(route.queryParams);
  if (!result.valid || !result.changed) return true; // geçersizse sayfa 404'ü kendisi verir

  // hedef sonuçsuzsa redirect etme: 404 bu URL'de verilsin (301 -> 404 zinciri olmasın)
  const path = [route.params['genre'], route.params['language']].filter(Boolean).join('/');
  try {
    await firstValueFrom(http.get(`${api}/api/catalog/${path}`, { params: result.params }));
  } catch {
    return true;
  }

  if (responseInit) responseInit.status = 301;
  return new RedirectCommand(router.createUrlTree([state.url.split('?')[0]], { queryParams: result.params }));
};
Bu guard iki denemenin sonucu. İlk sürümde API kontrolü yoktu; ?page=2&format=ebook isteğinde guard 301 ayarlayıp redirect etti, hedef sayfanın component'i API'den 404 alınca status'u 404'e çevirdi ve sunucunun yanıtı şu oldu:
$ curl -sI "http://127.0.0.1:52214/books/genre/science-fiction?page=2&format=ebook" | grep -iE "^(HTTP|content-type|location)"
HTTP/1.1 404 Not Found
content-type: text/html;charset=UTF-8
location: /books/genre/science-fiction?format=ebook&page=2
Boş gövdeli, Location header'lı bir 404: ne redirect ne düzgün bir hata sayfası. İkinci denemede API kontrolünü ekledim ama Router ve RESPONSE_INIT için inject() çağrılarını await'ten sonra bıraktım. inject() yalnız injection context içinde çalışıyor ve bu context ilk await'te kayboluyor; redirect dalı hiç çalışmadı ve normalize edilmesi gereken URL'lerin hepsi 404 döndü. inject()'leri fonksiyonun başına taşımak sorunu çözdü. Sonuç, ASP.NET Core sürümüyle aynı tablo:
# Angular SSR sunucusu
$ B=http://127.0.0.1:52214
$ while read -r u; do printf "%-55s %s %s\n" "$u" "$(curl -s -o /dev/null -w '%{http_code}' "$B$u")" "$(curl -sI "$B$u" | grep -i '^location' | tr -d '\r')"; done < urls.txt
/books/genre/science-fiction?page=2                     200
/books/genre/science-fiction?page=1                     301 location: /books/genre/science-fiction
/books/genre/science-fiction?sort=year&format=ebook     301 location: /books/genre/science-fiction?format=ebook&sort=year
/books/genre/science-fiction?page=2&format=ebook        404
/books/genre/science-fiction?page=9                     404
/books/genre/science-fiction?format=ebook&format=ebook  404
/books/genre/fantasy/tr                                 404
/books/genre/science-fiction/tr/tr                      404
404'ü component veriyor: API sonuç döndürmezse RESPONSE_INIT ile status 404 oluyor (serinin altıncı yazısındaki teknik). Sayfa link'leri routerLink ile basılıyor ve SSR (sayfanın sunucuda render edilmesi) çıktısında gerçek href olarak duruyor. Bir sınır da var: sunucu render'ı yalnız ilk istekte status verebilir. Kullanıcı uygulamanın içinde, istemci tarafında sonuçsuz bir filtreye geçerse ortada bir HTTP yanıtı yok; doküman da tek sayfalık uygulamalarda bunun her zaman mümkün olmadığını kabul edip JavaScript SEO'nun genel önerilerine yönlendiriyor (serinin sekizinci yazısı).
Üretimde Dikkat
Hangi filtrelerin index'leneceğini bir ürün kararı olarak yaz. "Türkçe bilim kurgu" aranan bir şey, "fiyata göre sıralanmış e-kitaplar" değil. Karar kodda tek bir yerde (Bookstore'da IsIndexable ve route) durmalı; sitemap, canonical ve robots.txt bu karardan türemeli.
Filtre sayfalarının maliyetini ölç. Doküman, filtreli URL'lerin crawl'ının sunucuya ciddi kaynak harcattığını hatırlatıyor. Index'lenecek filtre sayısını artırmadan önce log'lardan (serinin on birinci yazısı) bu URL'lere ne kadar crawl geldiğine bak.
robots.txt kurallarını testle. Wildcard'lı bir kuralın neyi engelleyip neyi bıraktığı ilk bakışta belli olmuyor; Bookstore'da bir test, beş örnek URL için beklenen izin durumunu doğruluyor.
Sık Düşülen Tuzaklar
Bütün sayfalı ve filtreli sayfaları birinci sayfaya canonical'lamak.
Sonuçsuz filtrede 200 dönen boş bir liste göstermek (soft 404, serinin altıncı yazısı) ya da ana sayfaya redirect etmek.
Normalize redirect'ini sonuç kontrolünden önce yapıp 301'den sonra 404'e düşmek.
Sayfa numarasını fragment'e (#page=2) koymak.
"Daha fazla yükle"yi <a href> karşılığı olmayan bir buton olarak yazmak.
Robots.txt ile engellenen sayfalara noindex ekleyip bunun işe yarayacağını düşünmek.
Google için rel="next"/rel="prev" eklemekle yetinip gerçek link'leri unutmak.
Küçük Bir Deneme
★☆☆ Kendi sitende bir liste sayfasının ikinci sayfasını aç ve kaynağında üç şeye bak: canonical kendisini mi gösteriyor, bir sonraki sayfaya <a href> var mı, birinci sayfaya link var mı?
★★☆ CatalogQuery'ye fiyat aralığı filtresi ekle (?min=100&max=300). min > max 404 dönsün, filtre robots.txt'de engellensin ve CatalogFacetTests'teki iki Theory'ye yeni satırlar ekle.
★★★ Infinite scroll'u gerçek bir kaydırma olayıyla yap: IntersectionObserver liste sonuna gelindiğinde bir sonraki sayfayı yüklesin, ekrana giren her sayfa için adres çubuğu history.replaceState ile o sayfanın ?page=n adresine dönsün. JavaScript kapalıyken "Sonraki" link'inin hâlâ çalıştığını doğrula.
Bu yazı boyunca her kuralı bir testle sabitledik; ama testler yalnız önceden düşündüğümüz URL'leri kontrol ediyor. Serinin son yazısında siteyi bir crawler gibi baştan sona gezen bir denetim kuracağız: Screaming Frog, Lighthouse'un SEO denetimleri, Bing Site Scan ve URL Inspection API'nin neyi gördüğünü karşılaştırıp CI'da çalışan kendi crawler'ımızı yazacağız.