

JavaScript SEO: CSR, SSR, SSG ve Googlebot'un Render Süreci

Index'lenecek içerik ilk HTML'de olmalı: Googlebot JavaScript'i render kuyruğunda çalıştırır, birçok crawler ise hiç çalıştırmaz. Aynı Angular sayfasını SSG, SSR ve CSR olarak curl ve headless Chrome ile ölçüyor, Lighthouse'un CSR sayfasına neden 100 verdiğini, dynamic rendering'in neden workaround olduğunu ve tıklamaya bağlı içerik gibi tuzakları görüyoruz.
Sürüm notu: Bu yazıdaki deneyler Angular 22.2 (@angular/ssr 22.2.6), Lighthouse 13.6.0 ve Google Chrome 156 ile yapılmıştır; Googlebot'un davranışı Google'ın JavaScript SEO (Search Engine Optimization) dokümanının Kasım 2026 hâli esas alınarak anlatılmıştır.
Önce Tahmin Et
Bookstore ekibi katalog sayfalarını tamamen client-side çalışan bir Angular uygulamasına taşımayı düşünüyor. Bir geliştirici kitap sayfasını Lighthouse'ta denemiş: SEO kategorisinde 100 puan. "Lighthouse 100 diyorsa Google da sorunsuz görür" diyor.
İki soru. Lighthouse'un 100 vermesi, sunucunun gönderdiği HTML'de (HyperText Markup Language) kitabın adının olduğu anlamına gelir mi? Ve Google bu sayfayı sorunsuz index'lese bile, JavaScript çalıştırmayan bir crawler aynı sayfada ne görür?
Serinin önceki yazılarında hep sunucunun gönderdiği yanıta baktık: status code, header, HTML'deki tag'ler. Bu yazıda o yanıtın içeriğinin nerede ve ne zaman oluştuğuna bakıyoruz: CSR (Client-Side Rendering), SSR (Server-Side Rendering) ve SSG (Static Site Generation). Hangi render modunun hangi route'a uygun olduğunu Angular'da nasıl kuracağımızı bir sonraki yazıya bırakıp, burada farkı ölçeceğiz.
Googlebot'un Üç Aşaması: Crawl, Render, Index
Google, JavaScript kullanan sayfaları üç aşamada işliyor. Crawl aşamasında Googlebot URL'yi (Uniform Resource Locator) istiyor; önce robots.txt'ye bakıyor, engellenmişse isteği hiç yapmıyor. Gelen HTML'den link'leri çıkarıp crawl kuyruğuna ekliyor. 200 dönen sayfalar render kuyruğuna giriyor; Google'ın ifadesiyle sayfa bu kuyrukta "birkaç saniye kalabilir, ama daha uzun da sürebilir". Render aşamasında headless bir Chromium sayfayı yükleyip JavaScript'i çalıştırıyor; Google bu render servisine WRS (Web Rendering Service) diyor. Render edilen HTML'den link'ler yeniden çıkarılıyor ve index'leme bu HTML ile yapılıyor.
Bu akıştan önceki yazılarda gördüğümüz birkaç kural çıkıyor. 200 dışındaki yanıtlar render'a hiç girmeyebilir. Orijinal HTML'de noindex varsa Google render'ı atlayabilir. robots.txt ile engellenmiş JavaScript ve CSS (Cascading Style Sheets) dosyaları render sırasında yüklenmez, sayfa eksik render edilir. İki kural da yeni: Google her kaynağı ayrı ayrı çekiyor ve Googlebot'un dosya boyutu sınırı (sıkıştırılmamış ilk 2 MB) her JavaScript ve CSS dosyası için ayrıca geçerli. Ayrıca WRS kaynakları agresif biçimde cache'liyor ve cache header'larını yok sayabiliyor; bu yüzden Google, dosya adına içeriğin hash'ini koyan content fingerprinting'i öneriyor. Angular CLI (Command Line Interface) bunu varsayılan olarak yapıyor: build çıktısında main-Y6BAQ67V.js gibi adlar var, içerik değişince ad da değişiyor.
Render'ın kaç saniye sürdüğü veya bir sayfanın ne kadar süre kuyrukta beklediği hakkında Google bir sayı vermiyor; "birkaç saniye, daha uzun da olabilir" dokümandaki tek ifade. Pratik sonuç: içeriği ilk HTML'de olan bir sayfa için render kuyruğu bir risk değil; içeriği yalnız render'dan sonra oluşan bir sayfa için ise index'lenme render'a bağımlı.
CSR, SSR, SSG ve Hybrid
Üç temel mod, HTML'in nerede ve ne zaman oluştuğuyla ayrışıyor:
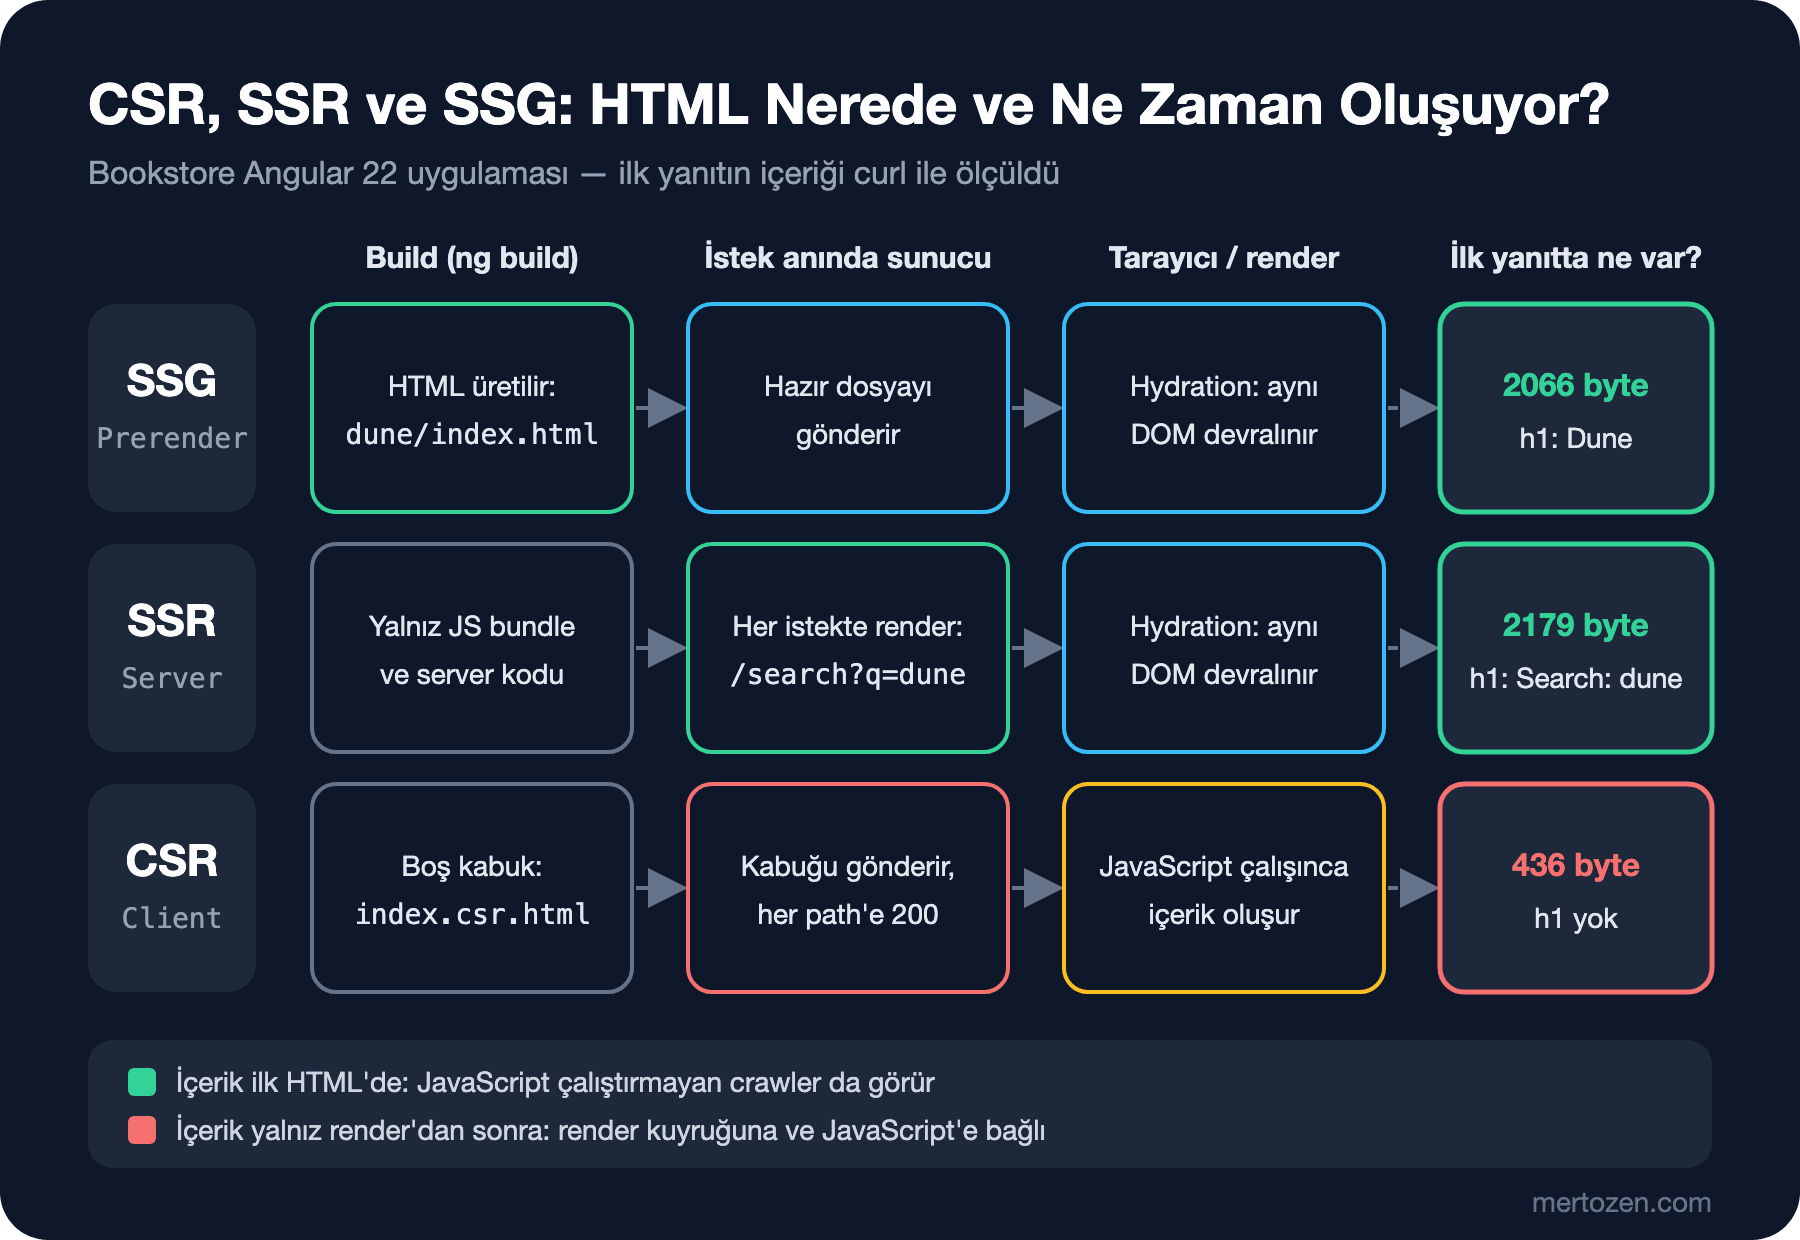
| Mod | HTML ne zaman oluşur | Crawler'ın ilk yanıtta gördüğü | Uygun olduğu içerik |
|---|---|---|---|
| SSG (prerender) | Build sırasında, bir kez | Tam içerik | Herkese aynı, seyrek değişen sayfalar: kitap detayı, blog yazısı |
| SSR | Her istekte, sunucuda | Tam içerik | İsteğe göre değişen, index'lenecek sayfalar: arama, filtreli listeler |
| CSR | Tarayıcıda, JavaScript çalışınca | Boş bir kabuk | Index'lenmeyecek, kişiye özel ekranlar: hesap, sepet, admin |
Hybrid rendering, aynı uygulamada route başına mod seçmek demek; Angular 19'dan beri server route'larla yapılabiliyor ve modern Angular'ın varsayılan yaklaşımı. SSR ve SSG'de tarayıcı, sunucudan gelen HTML'i atıp yeniden çizmek yerine hydration ile devralıyor; kullanıcı içeriği JavaScript yüklenmeden görüyor, etkileşim JavaScript yüklenince başlıyor.
Deney: Aynı Sayfa, Üç Render Modu
Bookstore'un Angular uygulamasında aynı BookDetail component'i iki route'ta duruyor: /books/:slug prerender ediliyor, /client/books/:slug ise RenderMode.Client ile servis ediliyor. Arama sayfası /search her istekte sunucuda render ediliyor. JavaScript çalıştırmayan bir istemci olarak curl ile ilk yanıtlara baktım:
/books/dune            bytes=2066   title=Dune_|_Bookstore h1=Dune
/search?q=dune         bytes=2179   title=Search_|_Bookstore h1=Search:_dune
/client/books/dune     bytes=436    title=BookstoreNg h1=
CSR route'unun gönderdiği 436 byte'ın tamamı bu:
<!doctype html>
<html lang="en" data-beasties-container="">
<head>
  <meta charset="utf-8">
  <title>BookstoreNg</title>
  <base href="/">
  <meta name="viewport" content="width=device-width, initial-scale=1">
  <link rel="icon" type="image/x-icon" href="favicon.ico">
<link rel="stylesheet" href="styles-5INURTSO.css"></head>
<body ngcm="">
  <app-root></app-root>
<script src="main-Y6BAQ67V.js" type="module"></script></body>
</html>
Başlık uygulamanın varsayılanı, açıklama yok, canonical yok, içerik yok; yalnız boş bir <app-root> ve bir script. Prerender edilmiş sayfada ise aynı component'in çıktısı HTML'in içinde, hatta Angular hangi yoldan geldiğini de yazıyor:
<app-root ng-version="22.2.5" ngh="1" ng-server-context="ssg">
...
<app-book-detail ngh="0">
<h1>Dune</h1>
<p>Frank Herbert</p>
<p>A desert planet, a noble family and the spice that everyone wants.</p>
/books/dune ng-server-context="ssg"
/search?q=dune ng-server-context="ssr"
/client/books/dune (none)ng-server-context attribute'u, bir sayfanın production'da gerçekten hangi modla servis edildiğini kontrol etmenin en hızlı yolu. ngh attribute'ları ve sayfanın sonundaki ng-state script'i hydration'ın kullandığı bilgiler.
Google'ın URL Inspection aracındaki "rendered HTML" görünümünün yerel bir karşılığı, headless Chrome'un render sonrası DOM'u (Document Object Model) yazdırması. Chrome'u geçici bir profil klasörüyle çalıştırdım:
$ "/Applications/Google Chrome.app/Contents/MacOS/Google Chrome" --headless=new --disable-gpu --no-first-run \
    --user-data-dir=./chrome-tmp --dump-dom http://localhost:20110/client/books/dune > csr.dom.html
$ grep -o '<title>[^<]*</title>\|<h1>[^<]*</h1>\|<link rel="canonical"[^>]*>' csr.dom.html
<title>Dune | Bookstore</title>
<link rel="canonical" href="https://bookstore.example/books/dune">
<h1>Dune</h1>
Render edildikten sonra CSR sayfası da doğru başlık, canonical ve içeriğe sahip. Googlebot da render ettiği sürece aynısını görecek. Fark, sayfanın içeriğe ulaşmak için render'a bağımlı olması: render kuyruğunda bekleme, render'ın bir nedenle başarısız olması (zaman aşımı, engellenmiş bir kaynak, bir JavaScript hatası) ve JavaScript çalıştırmayan bütün diğer istemciler.
Lighthouse Ne Ölçer, Ne Ölçmez?
Açılıştaki ilk sorunun cevabı için üç sayfada Lighthouse'un yalnız SEO kategorisini çalıştırdım:
$ npx lighthouse http://localhost:20110/client/books/dune --only-categories=seo --output=json \
    --chrome-flags="--headless=new --user-data-dir=./chrome-tmp"
# üç sayfanın JSON raporlarından özet:
/books/dune seo= 100 lighthouse 13.6.0 fails= []
/client/books/dune seo= 100 lighthouse 13.6.0 fails= []
/search?q=dune seo= 63 lighthouse 13.6.0 fails= [('is-crawlable', 0)]
CSR sayfası da 100 aldı, çünkü Lighthouse sayfayı gerçek bir Chrome'da yükleyip JavaScript'i çalıştırdıktan sonra denetliyor. Title, meta description, canonical, link'ler, status code: hepsi render sonrası DOM'da doğru. Lighthouse'un SEO kategorisi "render edilmiş sayfa temel SEO kurallarına uyuyor mu?" sorusunun cevabı; "JavaScript çalıştırmayan bir crawler ilk yanıtta ne görüyor?" sorusunun cevabı değil. İkincisi için curl ile ilk HTML'e bakmak gerekiyor. Yani açılıştaki geliştiricinin cümlesi yarı doğru: Google büyük ihtimalle görür, ama Lighthouse bunu kanıtlamıyor.
Arama sayfasının 63 alması ise ayrıca öğretici. Lighthouse'un is-crawlable denetimi iki sebep gösterdi: sayfadaki <meta name="robots" content="noindex"> ve robots.txt'nin birinci satırı. Bu yazı serisinin ikinci yazısında Angular'ın public/robots.txt'sine Disallow: /search koymuştum, üçüncü yazıda arama sayfasına noindex verdim. Üçüncü yazıda anlattığım çelişki tam bu: robots.txt crawl'ı engellediği için Google sayfadaki noindex'i hiç göremez. Kendi demo'mda bunu Lighthouse yakaladı; arama sonuçlarını index dışında tutmak için iki mekanizmadan birini seçmek gerekiyor.
Link'ler, Routing ve Diğer JavaScript Tuzakları
Render başarılı olsa bile JavaScript ile yapılan bazı şeyler crawler için görünmez kalıyor. Google yalnız href'i olan <a> element'lerini link olarak takip ediyor; (click) handler'ı olan bir buton veya <div> crawler için link değil. Fragment'lı route'lar (#/books/dune) Google tarafından güvenilir biçimde çözülemiyor; History API (Application Programming Interface) kullanılmalı. Bu ikisini serinin ilk yazısında Angular üzerinde görmüştük.
Kullanıcı etkileşimi bekleyen içerik de bir risk: "Daha fazla göster" butonuna tıklanınca yüklenen yorumlar veya bir sekmeye tıklanınca çekilen açıklama, Googlebot tıklamadığı için render edilen HTML'e girmeyebilir. Index'lenmesini istediğin içerik sayfa yüklendiğinde DOM'da olmalı; görsel olarak gizli olabilir (sekme, akordiyon), ama oluşması bir tıklamaya bağlı olmamalı. Google shadow DOM'u ve light DOM'u render sırasında düzleştiriyor; web component'lerin içindeki içerik de render edilen HTML'de görünür olduğu sürece index'lenebiliyor.
Lazy loading'de de aynı mantık: görselleri ve içeriği görünür alana girince yüklemek performans için doğru, ama tetikleyici yalnız scroll event'iyse ve Googlebot sayfayı kaydırmıyorsa içerik hiç yüklenmeyebilir. Google'ın lazy loading rehberi loading="lazy" veya IntersectionObserver kullanmayı öneriyor. Angular'ın @defer block'ları SSR'da varsayılan olarak placeholder'ı render ediyor; index'lenmesi gereken içeriği @defer arkasına koymadan önce sunucunun ne gönderdiğini kontrol et.
Dynamic Rendering Neden Kalıcı Çözüm Değil
Bir dönem önerilen bir ara çözüm vardı: sunucu user-agent'a bakar, botlara önceden render edilmiş HTML, kullanıcılara CSR uygulaması gönderir. Google bugün bunu açıkça bir workaround sayıyor ve önermiyor; dokümanındaki ifade "dynamic rendering bir workaround'dı ve uzun vadeli bir çözüm değil". Gerekçe pratik: iki ayrı render yolunu (bot için ve kullanıcı için) senkron tutmak ek karmaşıklık ve kaynak demek, user-agent tespiti kırılgan ve ikisinin içerikleri ayrıştığında ortaya cloaking'e benzeyen bir durum çıkabilir. Google'ın önerdiği alternatifler SSR, statik render (prerender) ve hydration; Angular'ın hybrid rendering'i tam bunları sağlıyor.
JavaScript Çalıştırmayan Crawler'lar
Google render ediyor, ama web'i tarayan tek istemci Google değil. Sosyal ağların link önizleme bot'ları, mesajlaşma uygulamalarının link unfurler'ları, bazı arama motorlarının crawler'ları ve AI (Artificial Intelligence) şirketlerinin crawler'ları genellikle yalnız ilk HTML'i okuyor. Vercel ve MERJ'in (bir SEO ve veri danışmanlık şirketi) Aralık 2024'te yayımladığı bir analiz, 500 milyondan fazla GPTBot isteğinde JavaScript çalıştırıldığına dair bir kanıt bulmadığını ve ClaudeBot dahil incelenen büyük AI crawler'larının JavaScript render etmediğini bildirdi. Bu bir şirketin ölçümü; crawler sahiplerinin dokümanlarında bu davranış her zaman açıkça yazmıyor ve durum zamanla değişebilir. AI bot'larının türleri ve nasıl yönetileceği GEO (Generative Engine Optimization) serisinin "AI Bot'larını Tanımak ve Yönetmek" yazısının konusu.
Bu yazı açısından çıkarım basit: index'lenmesini, alıntılanmasını veya paylaşıldığında doğru önizlenmesini istediğin içerik ilk HTML'de olmalı. Açılıştaki CSR sayfası Google'da büyük ihtimalle görünür, ama JavaScript çalıştırmayan bir crawler'a gösterdiği şey BookstoreNg başlıklı boş bir sayfa.
Üretimde Dikkat
Production'da her önemli şablon için iki kontrolü otomatikleştir: curl ile ilk HTML'de başlık, canonical ve ana içeriğin bir parçası var mı; headless Chrome ile render edilen DOM'da aynı değerler var mı? İkisi arasındaki fark, içeriğin ne kadarının JavaScript'e bağımlı olduğunu gösterir. Search Console'un URL Inspection aracındaki "Test Live URL" ve rendered HTML görünümü, Google'ın kendi render'ını gösteren tek kaynak; yerel testler onun yerini tutmaz, onu tamamlar.
Render'ı kıran JavaScript hatalarını izle. Bir third-party script'in hata fırlatması, CSR uygulamasında bütün içeriğin oluşmamasına yol açabilir; SSR'da ise içerik zaten HTML'de olduğu için zarar sınırlı kalır. Bu, SSR'ın SEO dışındaki dayanıklılık getirisi.
mertozen.com bu açıdan şanslı bir konumda: site ASP.NET Core MVC (Model-View-Controller) ile sunucuda render ediliyor, yazının içeriği, başlığı, canonical'ı ve hreflang'ı ilk HTML'de geliyor; JavaScript tema düğmesi ve slider gibi etkileşimler için kullanılıyor; blog haritası gibi tek tük bileşenler ise veriyi bir JSON (JavaScript Object Notation) endpoint'inden alıp tarayıcıda çiziyor, yani yalnız o bileşenlerin içeriği render'a bağımlı. CSS ve JavaScript dosyaları ise asp-append-version ile URL'ye eklenen bir hash parametresiyle versiyonlanıyor; dosya adı değişmese de URL değiştiği için WRS'nin cache'inde eski dosyanın kullanılma riski aynı şekilde ortadan kalkıyor.
Sık Düşülen Tuzaklar
Lighthouse SEO puanını "crawler ne görüyor?" sorusunun cevabı sanmak. Lighthouse render edilmiş sayfayı denetler; ilk HTML'i değil.
Title, meta description ve canonical'ı yalnız tarayıcıda ayarlamak. CSR'da bu tag'ler ilk HTML'de yok; Google render ederse görür, diğer istemciler görmez.
İçeriği tıklamaya bağlamak. Googlebot butonlara tıklamaz; "Daha fazla" ile yüklenen içerik index'lenmeyebilir.
JavaScript ve CSS dosyalarını robots.txt ile engellemek. Render eksik kalır; CSR'da içerik tamamen kaybolur.
Dynamic rendering'i yeni bir projede çözüm olarak seçmek. Google bunu workaround sayıyor; hybrid rendering daha sade ve dayanıklı.
Küçük Bir Deneme
★☆☆ Kendi sitenden bir sayfayı curl -s ile indir ve sayfanın başlığını, ana başlığını (h1) ve ilk paragrafını HTML'de ara. Bulamadıkların JavaScript'e bağımlı.
★★☆ Aynı sayfa için curl çıktısındaki görünür metnin kelime sayısını headless Chrome'un --dump-dom çıktısıyla karşılaştıran küçük bir script yaz. Oranı "ilk HTML'deki içerik yüzdesi" olarak raporla ve Bookstore'un üç route'unda çalıştır.
★★★ Bookstore'un CSR route'una bir Lighthouse custom audit'i veya basit bir Node.js kontrolü ekle: sayfayı JavaScript devre dışı (--blink-settings=scriptEnabled=false) bir Chrome ile yükleyip h1'in varlığını kontrol etsin ve CI'da (Continuous Integration) bu kontrol kırmızıya dönsün.
Fark ortada: index'lenecek içerik ilk HTML'de olmalı. Bir sonraki yazıda bunu Angular'da route route kuruyoruz: app.routes.server.ts'te RenderMode seçimi, getPrerenderParams ile prerender, Title ve Meta service'leri, REQUEST ve RESPONSE_INIT token'ları, hydration ve SSR'ın güvenlik tarafındaki allowedHosts ayarı.