

Amortized Analysis: List<T>.Add Neden O(1) Sayılır
List<T>.Add bazen bütün listeyi kopyalar ama kapasite ikiye katlandığı için n Add'in toplam maliyeti 3n'i geçmez; bu yüzden amortized O(1) sayılır. Aggregate, accounting ve potential method, +10 büyümenin 50 milyar kopyası, Dictionary'nin asal boyutları ve 38 ms'lik resize spike'ı gerçek ölçümlerle.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; ölçümler BenchmarkDotNet 0.15.8, testler xUnit v3 4.0.2 ile alınmıştır.
Önce Tahmin Et
List<T>.Add'in Microsoft Learn sayfasındaki Remarks bölümü şöyle der: Count, Capacity'den küçükse bu method O(1); kapasitenin artırılması gerekiyorsa O(n), n burada Count. Yani bazı Add çağrıları bütün listeyi yeni bir array'e kopyalıyor.
Boş bir List<int>'e bir milyon element ekliyorsun. Bütün bu Add'ler boyunca toplamda kaç element kopyalanır? Bir milyon civarı mı, yirmi milyon mu (her resize'da ortalama yarım liste, log₂ n kez), yoksa yüz milyarlar mı? Bir de şu: listeyi her seferinde iki katına değil de 10 element büyütseydik sayı ne olurdu?
Amortized Analysis Neyi Ölçer
Şimdiye kadar her işlemin maliyetine tek tek baktık. Add için bu bakış iki farklı cevap veriyor: çoğu zaman O(1), arada bir O(n). Worst case'i esas alırsak "n tane Add O(n²)" deriz ve yanılırız; çünkü pahalı Add'ler çok seyrek.
Amortized analysis bir işlem dizisinin toplam maliyetine bakar ve onu işlem sayısına böler. "Add amortized O(1)" demek, "n tane Add'in toplam maliyeti O(n)" demek. Bu bir average case değil: olasılık yok, rastgele girdi varsayımı yok. Her olası Add dizisi için, en kötüsü dahil, garanti edilen bir üst sınır. CLRS (Cormen, Leiserson, Rivest ve Stein'ın Introduction to Algorithms kitabı) bunu "her işlemin ortalama performansını, worst case'de garanti eden" analiz olarak tanımlar.
Kopyaları Saymak: Kendi Dynamic Array'imiz
Teoriye girmeden önce sayalım. List<T>'in iç mantığını taklit eden, büyüme politikası seçilebilen ve resize'larda kaç element kopyaladığını sayan küçük bir class yazdım:
public enum GrowthPolicy { Doubling, PlusTen }

// Resize'ların kaç element kopyalamaya mal olduğunu sayan minimal bir dynamic array.
public sealed class GrowableArray<T>(GrowthPolicy policy, int initialCapacity = 4)
{
    private T[] _items = new T[initialCapacity];

    public int Count { get; private set; }
    public int Capacity => _items.Length;
    public long CopiedElements { get; private set; }
    public int Resizes { get; private set; }

    public void Add(T item)
    {
        if (Count == _items.Length)
        {
            var newCapacity = policy == GrowthPolicy.Doubling ? _items.Length * 2 : _items.Length + 10;
            var bigger = new T[newCapacity];
            Array.Copy(_items, bigger, Count);
            CopiedElements += Count;
            Resizes++;
            _items = bigger;
        }
        _items[Count++] = item;
    }

    public T this[int index] => index < Count ? _items[index] : throw new ArgumentOutOfRangeException(nameof(index));
}
İki politikayla 1.000'den 1.000.000'a kadar element ekleyince gerçek sayılar:
         n  doubling copies  per add       +10 copies    per add
     1,000            1,020     1.02           49,900       49.9
    10,000           16,380     1.64        4,999,000      499.9
   100,000          131,068     1.31      499,990,000     4999.9
 1,000,000        1,048,572     1.05   49,999,900,000    49999.9
İkiye katlayan array, bir milyon Add boyunca toplam 1.048.572 element kopyaladı: Add başına bir kopyadan biraz fazla. Sabit +10 büyüyen array ise 49,9 milyar element kopyaladı; Add başına yaklaşık n/20. Tahmin bölümündeki sorunun cevabı: ikiye katlamada yaklaşık bir milyon, +10'da elli milyar.
"Add başına kopya" sütununun 1,02 ile 1,64 arasında oynaması dikkatini çekmiş olabilir. Sebep, n'in son resize'a göre nerede durduğu. n = 10.000'de son resize 8.192'den 16.384'e oldu ve 8.192 element kopyalandı; n, yeni kapasitenin daha başında. Ama oran hiçbir zaman 2'yi geçmiyor. Nedenini şimdi göreceğiz.
Üç İspat Yöntemi
Amortized maliyeti kanıtlamanın üç klasik yolu var. Üçü de aynı sonuca varır; farkları, hangi sezgiyi öne çıkardıkları.
Aggregate method: toplamı hesapla, böl
En doğrudan yol toplam maliyeti hesaplamak. Kapasite 4'ten başlıyor ve her dolduğunda ikiye katlanıyor. n Add boyunca resize'lar 4, 8, 16, … , 2ᵏ element'te olur; 2ᵏ < n. Toplam kopya:
4 + 8 + 16 + ... + 2^k  =  2^(k+1) - 4  <  2 * 2^k  <  2n

cost(n Add)  =  n + copies  <  n + 2n  =  3n     // toplam maliyet: n yazma + kopyalar
amortized    =  3n / n  =  3  ->  O(1)
Geometrik bir serinin toplamı son teriminin iki katını geçemez. Bu tek cümle bütün analizin kalbi. Aşağıdaki grafik ilk 33 Add'in maliyetini çiziyor:
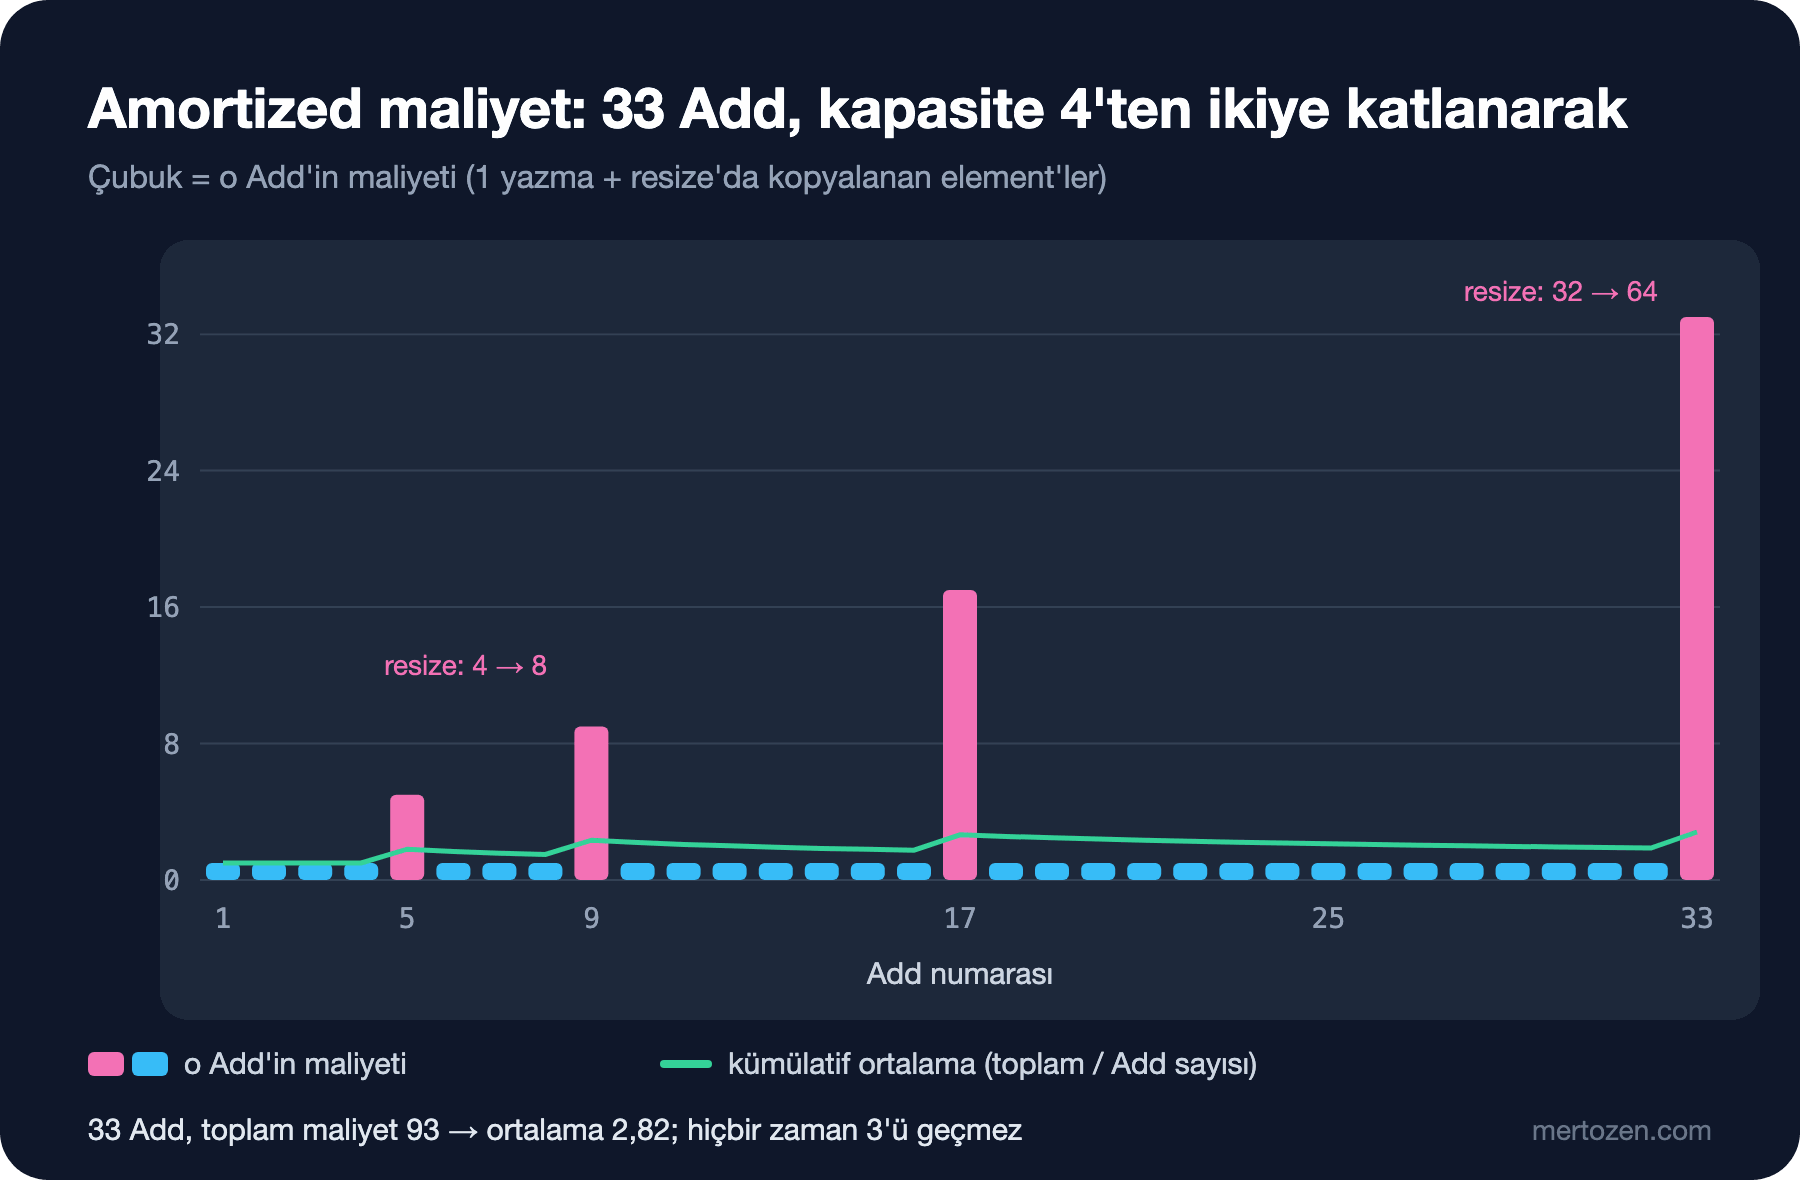
Pembe çubuklar resize anları: 5., 9., 17. ve 33. Add'ler sırasıyla 4, 8, 16 ve 32 element kopyalıyor. Çubuklar büyüyor ama aralarındaki mesafe de aynı oranda büyüyor; yeşil çizgi, yani o ana kadarki ortalama, hiçbir zaman 3'ü geçmiyor. 33 Add'in toplam maliyeti 93, ortalaması 2,82.
Accounting (banker's) method: her Add 3 jeton öder
İkinci yöntem bir muhasebe hikâyesi. Her Add'e gerçek maliyetinden fazla, sabit 3 jeton fiyat biçeriz. 1 jeton element'i yazmaya harcanır. Kalan 2 jeton o element'in üzerine "kredi" olarak bırakılır.
Kapasite C'den 2C'ye çıkarken C element kopyalanmalı. Son resize'dan bu yana yeni eklenen element sayısı C/2 ve her birinin üzerinde 2 jeton var: toplam C jeton. Bu jetonlar kopyalamayı tam olarak öder. Banka hesabı hiçbir zaman eksiye düşmüyorsa, ödenen toplam (3n) gerçek toplam maliyetin üst sınırıdır. Bu yöntemin güzelliği, "pahalı işlemin bedelini önceden ucuz işlemler ödedi" sezgisini doğrudan vermesi.
Potential method: yapının içinde biriken enerji
Üçüncü yöntem jetonları tek tek element'lere değil, bütün veri yapısına bağlar. Bir potential fonksiyonu tanımlarız: Φ = 2·Count − Capacity. Resize'dan hemen sonra array yarı dolu, Φ ≈ 0. Her ucuz Add Φ'yi 2 artırır. Array dolduğunda Φ = Capacity olur ve resize'ın kopyalama maliyeti bu biriken potential'den ödenir. Amortized maliyet = gerçek maliyet + ΔΦ; ucuz Add için 1 + 2 = 3. Resize'lı Add'de gerçek maliyet C + 1, Φ ise C'den 2'ye düşer (ΔΦ = 2 − C); toplam yine 3. Potential method, splay tree ve Fibonacci heap gibi daha karmaşık yapıların analizinde standart araç; günlük işte sezgi için ilk ikisi yeter.
Neden ×2: Sabit +10 Büyümenin Bedeli
Aynı aggregate hesabını +10 büyüme için yapalım. n Add'de yaklaşık n/10 resize olur ve i'nci resize'da 10·i element kopyalanır:
10 + 20 + 30 + ... + n  =  10 * (1 + 2 + ... + n/10)  ~  n^2 / 20

amortized  ~  n / 20  ->  O(n)     // Add başına maliyet n ile büyür
Tablodaki 49.999.900.000 tam olarak bu: 1.000.000² / 20. Aritmetik büyüme, n büyüdükçe sabit kalan adımlar demek; geometrik büyüme ise adımın listeyle orantılı büyümesi. Amortized O(1) için büyüme faktörünün 2 olması şart değil; 1'den büyük herhangi bir sabit çarpan (1,5 gibi) yeter. Faktör küçüldükçe boşta duran bellek azalır ama resize sayısı ve toplam kopya artar. .NET List<T> için 2'yi seçmiş. BenchmarkDotNet ile 100.000 Add:
| Method              | N      | Mean         | Ratio  | Allocated     |
|-------------------- |------- |-------------:|-------:|--------------:|
| ListAdd             | 100000 |    128.44 us |   1.00 |    1024.58 KB |
| ListAddWithCapacity | 100000 |     84.13 us |   0.66 |     390.76 KB |
| GrowableDoubling    | 100000 |    137.05 us |   1.07 |    1024.55 KB |
| GrowablePlusTen     | 100000 | 86,243.56 us | 673.58 | 1954092.54 KB |
Bizim doubling array'imiz List<T> ile aynı hızda ve aynı allocation'la çalışıyor (1.024 KB: 4'ten 131.072'ye kadar bütün ara array'lerin toplamı). +10 büyüyen array 673 kat yavaş ve 1,9 GB allocation yapıyor: her resize yeni bir array ayırdığı için bellek tarafında da aynı n²/20 hesabı geçerli. Kapasiteyi baştan veren List<T> ise hiç resize yapmadığı için yüzde 34 daha hızlı ve yalnızca tek bir 390 KB'lık array ayırıyor. Amortized O(1) ile gerçek O(1) arasındaki fark bu yüzde 34.
.NET'te List<T>, Dictionary ve Diğerleri
Teoriyi gerçek collection'larda gözlemleyelim. 1.000 element eklerken List<int>.Capacity'nin ve Dictionary<int, int>.EnsureCapacity(0)'ın (mevcut kapasiteyi döner) aldığı değerler:
List<int>       : 0 -> 4 -> 8 -> 16 -> 32 -> 64 -> 128 -> 256 -> 512 -> 1024
Dictionary<,>   : 0 -> 3 -> 7 -> 17 -> 37 -> 89 -> 197 -> 431 -> 919 -> 1931
List<T> boş başlıyor, ilk Add'de 4'e çıkıyor ve sonra her seferinde ikiye katlanıyor. Dictionary ise dotnet/runtime kaynak kodundaki HashHelpers.ExpandPrime ile büyüyor: eski boyutun iki katını alıp ondan büyük ilk asal sayıyı seçiyor (7 → 14 → 17, 17 → 34 → 37). Asal boyut, hash'lerin bucket'lara daha düzgün dağılmasına yardım ediyor. Büyüme yine geometrik, dolayısıyla Add yine amortized O(1). Resize sırasında dictionary bütün entry'leri yeni bucket'lara yeniden dağıttığı için o tek işlem, listede olduğu gibi O(n). API (Application Programming Interface) ayrıntıları C# Koleksiyonlar serisindeki "C# List<T> Rehberi: Ekleme, Silme, Capacity, Sıralama ve Arama" ve "C# Dictionary ve HashSet: TryGetValue, Key Eşitliği ve Comparer" yazılarında.
Aynı fikir başka yerlerde de var. Queue<T> bir circular buffer; dolduğunda kaynak koddaki GrowFactor = 2 ile ikiye katlanır (en az 4 element büyür) ve element'leri yeni array'in başına sırayla kopyalar. StringBuilder farklı bir yol seçer: dolunca mevcut karakterleri kopyalamaz, yeni bir chunk ekler. Yeni chunk'ın boyutu o ana kadarki uzunluk kadardır ama 8.000 karakterle (MaxChunkSize) sınırlıdır. Kopyalama hiç olmadığı için Append amortized O(1); bedeli, ToString()'in chunk'ları birleştirmesi. Algoritmalar ve Data Structures serisinin Union-Find yazısında path compression'ın da amortized bir argümanla neredeyse sabit zamana indiğini göreceğiz.
Amortized, Her İşlem Hızlı Demek Değil
Amortized O(1) toplam için bir garanti. Tek bir işlem için hiçbir şey vaat etmez. 40 milyon long'u boş bir listeye eklerken her Add'i Stopwatch ile ölçtüm ve 1 milisaniyeyi geçenleri yazdırdım:
presize=False n=40,000,000 total=1,165 ms adds over 1 ms: 5
  Add #  2,097,152 (Count 2,097,152 -> capacity 4,194,304) took    1.34 ms
  Add #  4,194,304 (Count 4,194,304 -> capacity 8,388,608) took    3.06 ms
  Add #  8,388,608 (Count 8,388,608 -> capacity 16,777,216) took    6.12 ms
  Add # 16,777,216 (Count 16,777,216 -> capacity 33,554,432) took   14.35 ms
  Add # 33,554,432 (Count 33,554,432 -> capacity 67,108,864) took   38.48 ms
presize=True n=40,000,000 total=1,100 ms adds over 1 ms: 0
40 milyon Add'in toplamı 1,1 saniye; ortalaması 30 nanosaniyenin altında. Ama 33.554.433'üncü Add tek başına 38 milisaniye sürdü: 256 MB'lık bir array'i 512 MB'lık yenisine kopyaladı. Her resize'da süre kabaca ikiye katlanıyor, çünkü kopyalanan veri ikiye katlanıyor. Bu, amortized analysis'in tam olarak söylediği şey: maliyet yok olmuyor, seyrek anlara yığılıyor.
Listeyi new List<long>(n) ile önceden boyutlandırınca 1 milisaniyeyi geçen tek bir Add kalmadı. Kapasiteyi önceden bilmiyorsan ama yaklaşık bir tahminin varsa EnsureCapacity aynı işi sonradan yapar. Dikkat: büyük resize'lar yalnızca kopyalama değil, 85.000 byte'ı aşan array'ler için LOH (Large Object Heap) allocation'ı ve eski array'in çöpe gitmesi demek; ikisi de GC (Garbage Collector) üzerinde ek baskı.
Üretimde Dikkat
Throughput odaklı kodda (batch işler, rapor üretimi, ETL (Extract, Transform, Load) süreçleri) amortized O(1) yeterli bir garanti. Toplam süre önemli ve resize spike'ları toplamın içinde eriyor.
Latency odaklı kodda durum farklı. p99 (isteklerin yüzde 99'unun altında kaldığı süre) hedefi olan bir API'de, büyük bir in-memory collection'ı request sırasında büyütmek o request'in süresine 40 milisaniye ekleyebilir. Oyun döngüsü, ses işleme, trading gibi real-time yollarda ise tek bir spike kabul edilemez. Bu yollarda üç şey yap: kapasiteyi önceden ayır, collection'ları request'ler arasında yeniden kullan (Clear() kapasiteyi korur) ve ölçümünü ortalama ile değil yüksek percentile'larla yap.
Ters yön de var: büyüyen collection hiç küçülmez. List<T>.Clear() ve RemoveAt kapasiteyi düşürmez; bir kez 10 milyon element'e çıkan bir cache listesi, boşalsa bile 10 milyonluk array'i tutar. Gerçekten küçültmek istiyorsan TrimExcess() çağır; ama bunu bir döngü içinde yaparsan büyüme-küçülme salınımıyla amortized garantiyi kaybedebilirsin.
Sık Düşülen Tuzaklar
Amortized'ı average case sanmak. Amortized analysis'te olasılık yok; her girdi için geçerli bir toplam garanti var. Average case ise girdinin dağılımına bağlı.
Amortized O(1)'i "her çağrı hızlı" diye okumak. Toplam ucuz, tek çağrı pahalı olabilir. Latency hedefin varsa spike'ı ölç.
Kendi buffer'ını sabit adımla büyütmek. new byte[old.Length + 4096] tarzı kod, büyük girdilerde O(n²) toplam kopya üretir. Geometrik büyü.
Kapasiteyi bildiğin hâlde vermemek. new List<T>(source.Count) veya new Dictionary<TKey, TValue>(count) bütün resize'ları ortadan kaldırır; Select(...).ToList() kaynak boyutunu biliyorsa bunu zaten kendisi yapar.
Resize'ın bellek tepe noktasını unutmak. Kopyalama sırasında eski ve yeni array aynı anda bellektedir: 256 MB'lık listeyi büyütmek bir an için 768 MB demek.
Küçük Bir Deneme
★☆☆ GrowableArray'e 1,5 çarpanlı bir GrowthPolicy ekle. 1.000.000 Add için toplam kopya sayısı ve son kapasite ne oluyor? Doubling ile karşılaştır.
★★☆ Bir Stack implementasyonu düşün: kapasite dolunca ikiye katlansın, Count kapasitenin yarısının altına düşünce yarıya insin. Kapasite tam sınırdayken art arda Push, Pop, Push, Pop yapan bir dizi neden O(n²) olur? Küçültme eşiğini dörtte bire çekmek bunu nasıl düzeltir?
★★★ Dictionary<int, int>'e 10 milyon key eklerken en yavaş 5 işlemi ölç (yukarıdaki spike kodu gibi). Resize anlarını EnsureCapacity(0) ile doğrula ve aynı denemeyi constructor'a kapasite vererek tekrarla.
Bu seride şimdiye kadar hep sayılarla ve sınırlarla çalıştık. Ama gördüğün gibi gerçek süre bazen teorinin söylediğinden saparken (149 kat yerine 100 kat, 18 kat yerine 10 kat) sebep hep teorinin dışında kalan bir şeydi: cache, GC, allocation. Serinin son yazısında Big-O'nun söylemediği bu şeylere bakıyoruz ve BenchmarkDotNet ile complexity'yi ölçerek tahmin etmeyi öğreniyoruz.