

Big-O Notation Nedir: Büyüme Hızı, O, Ω, Θ ve Worst Case
Big-O bir algoritmanın süresini saniyeyle değil, girdi boyutu n büyüdükçe adım sayısının nasıl büyüdüğüyle anlatır. O, Ω ve Θ farkı, n'i doğru seçmek, best/average/worst case ve List, HashSet ile binary search'ün 10 ile 1.000.000 element arasında BenchmarkDotNet ile ölçülmüş gerçek büyümesi.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; ölçümler BenchmarkDotNet 0.15.8, testler xUnit v3 4.0.2 ile alınmıştır.
Önce Tahmin Et
Bookstore kataloğunda bugün 1.000 kitap var. Ürün ekibi gelecek yıl için 1.000.000 kitap hedefliyor. Kodda ISBN (International Standard Book Number) ile kitap bulan üç farklı yol var: bir List<string> üzerinde Contains, bir HashSet<string> üzerinde Contains ve sıralı bir array üzerinde Array.BinarySearch. Bugün üçü de birkaç nanosaniye ile birkaç mikrosaniye arasında cevap veriyor.
Katalog bin kat büyüdüğünde her biri kaç kat yavaşlar? Bin kat mı, iki kat mı, hiç mi? Cevabını bir kenara yaz; yazının ortasında aynı makinede ölçtüğüm gerçek sayılarla karşılaştıracağız. Bir soru daha: HashSet "O(1)" olduğuna göre, 100.000 karakterlik bir key ile arama da 13 karakterlik key kadar hızlı mıdır?
"Kaç Saniye" Değil, "Nasıl Büyür"
Bir algoritmanın hızını saniyeyle anlatmak cazip ama işe yaramaz. Aynı kod bu yazıyı yazdığım Apple M5 makinede 1,4 mikrosaniye sürer, beş yıllık bir sunucuda üç katı, debug build'de on katı. Saniye; makineye, runtime'a, JIT (Just-In-Time) derleyicisinin o günkü kararına ve CPU (Central Processing Unit) cache'inin durumuna bağlı. Oysa asıl merak ettiğimiz şey başka: veri büyüdüğünde bu kod ne olacak?
Big-O notation bu soruya cevap veren dil. Bir algoritmanın attığı adım sayısını girdi boyutunun, yani n'in bir fonksiyonu olarak yazarız: T(n). Sonra bu fonksiyonun büyük n'lerde nasıl davrandığına bakarız. "Bu method O(n)" demek "n iki katına çıkınca süre de kabaca iki katına çıkar" demek; "O(n²)" ise "n iki katına çıkınca süre dört katına çıkar" demek. Saniye vermiyoruz, büyüme hızı veriyoruz.
Adım saymayı somutlaştıralım. Önce iki arama yazıp kaç karşılaştırma yaptıklarını sayıyoruz:
namespace Bookstore.Complexity;

public sealed record Book(string Isbn, string Title, string Author, decimal Price);

public static class CatalogSearch
{
    // Linear search: key'i bulana kadar her kitapla karşılaştırır.
    public static (Book? Book, int Comparisons) Linear(List<Book> books, string isbn)
    {
        var comparisons = 0;
        foreach (var book in books)
        {
            comparisons++;
            if (book.Isbn == isbn)
            {
                return (book, comparisons);
            }
        }
        return (null, comparisons);
    }

    // Isbn'e göre (ordinal) sıralı array üzerinde binary search.
    public static (Book? Book, int Comparisons) Binary(Book[] sortedBooks, string isbn)
    {
        int low = 0, high = sortedBooks.Length - 1, comparisons = 0;
        while (low <= high)
        {
            var mid = low + (high - low) / 2;
            comparisons++;
            var cmp = string.CompareOrdinal(sortedBooks[mid].Isbn, isbn);
            if (cmp == 0)
            {
                return (sortedBooks[mid], comparisons);
            }
            if (cmp < 0) low = mid + 1; else high = mid - 1;
        }
        return (null, comparisons);
    }
}
Demo uygulaması 1.000 ve 1.000.000 kitaplık iki katalog üretip ilk kitabı, son kitabı ve katalogda olmayan bir ISBN'i arıyor. Gerçek çıktı:
n = 1,000
  linear  best (first) : 1
  linear  worst (last) : 1,000
  linear  missing      : 1,000
  binary  last         : 10
  binary  missing      : 10
n = 1,000,000
  linear  best (first) : 1
  linear  worst (last) : 1,000,000
  linear  missing      : 1,000,000
  binary  last         : 20
  binary  missing      : 20
Linear search'te karşılaştırma sayısı n ile birlikte bin kat arttı. Binary search'te 10'dan 20'ye çıktı: n bin kat büyüdü, adım sayısı yalnızca 10 arttı. Bunun nedeni her karşılaştırmanın arama aralığını yarıya indirmesi; 1.000.000'u 20 kez ikiye bölünce 1'in altına inersin (2²⁰ = 1.048.576). İlki O(n), ikincisi O(log n).
n'i Doğru Seçmek
Analizin ilk ve en çok atlanan adımı n'in ne olduğuna karar vermek. Kataloğa göre n kitap sayısı. Ama aynı kodda başka büyüklükler de saklı olabilir:
- Bir string'in her karakterini gezen method için n kayıt sayısı değil, string uzunluğu.
- Siparişleri müşterilerle eşleştiren kodda iki bağımsız büyüklük var: n sipariş ve m müşteri. O(n·m) yazmak O(n²) yazmaktan daha dürüst; çünkü 1.000.000 sipariş ve 50 müşteri ile 1.000 sipariş ve 1.000 müşteri çok farklı sonuç verir.
- Yazarların ve her yazarın kitaplarının olduğu iç içe bir collection'da "her yazar için her kitabını gez" kodu, yazar sayısının karesi değildir. Toplam kitap sayısı K ise O(yazar + K) olur.
Son madde önemli bir tuzak. İç içe iki foreach gördüğün an "O(n²)" demek refleks hâline gelir. Oysa iç döngü dış döngünün her turunda aynı n element'i değil, o yazarın kendi kitaplarını geziyorsa toplam iş, bütün kitapların sayısı kadardır. Döngü sayısını değil, iç gövdenin toplamda kaç kez çalıştığını sayman gerekiyor.
O, Ω ve Θ: Üst Sınır, Alt Sınır, Sıkı Sınır
Gündelik dilde hep "Big-O" deriz ama literatürde üç ayrı sembol var. CLRS (Cormen, Leiserson, Rivest ve Stein'ın Introduction to Algorithms kitabı) tanımları şöyle verir:
f(n) = O(g(n))  <=>  exists c > 0, n0 : for all n >= n0, f(n) <= c * g(n)   // üst sınır
f(n) = Ω(g(n))  <=>  exists c > 0, n0 : for all n >= n0, f(n) >= c * g(n)   // alt sınır
f(n) = Θ(g(n))  <=>  f(n) = O(g(n)) and f(n) = Ω(g(n))                         // sıkı sınır
O yalnızca "bundan hızlı büyümez" der. Bu yüzden teknik olarak linear search hem O(n) hem de O(n²)'dir; ikisi de doğru bir üst sınır. Ama "O(n²)" demek kimseye bir şey anlatmaz. Θ ise "tam olarak bu hızda büyür" der. Mülakatlarda, code review'da ve dokümanlarda "bu method O(n)" denirken kastedilen neredeyse her zaman Θ(n)'dir. Bu yazıda ve serinin geri kalanında da gündelik kullanıma uyacağım; sıkı sınır olduğunu vurgulamam gerektiğinde Θ yazacağım.
Tanımın pratik sonucu iki basit kural: sabit çarpanları at, küçük terimleri at. Diyelim ki bir rapor kodunun adım sayısını saydın ve T(n) = 3n² + 20n + 5 çıktı. c = 4 ve n0 = 21 seçersek her n ≥ 21 için 3n² + 20n + 5 ≤ 4n² olur (n = 21'de 1.748 ≤ 1.764; n = 20'de ise 1.605 > 1.600, yani eşitsizlik tam olarak 21'den itibaren tutar). Yani T(n) = Θ(n²). 20n terimi n = 10'da toplamın yüzde 40'ını oluşturur, n = 10.000'de binde birinden az. Büyük n'de baskın terim kazanır.
Sabitleri atmak "sabitler önemsiz" demek değil. Sabitler gerçek süreyi belirler ve küçük n'de çoğu zaman sonucu da belirler. Big-O yalnızca büyümeyi karşılaştırır. Sabitlerin ve cache'in hikâyesini serinin son yazısına bırakıyoruz.
Best, Average ve Worst Case
İkinci karışıklık case ile bound'u birbirine katmaktan doğuyor. Best, average ve worst case girdinin hangi senaryosuna baktığımızı söyler; O, Ω ve Θ ise o senaryodaki maliyet fonksiyonunu nasıl sınırladığımızı. İkisi birbirinden bağımsız: "linear search'ün worst case'i Θ(n)" anlamlı bir cümle.
Yukarıdaki çıktı üç case'i de gösteriyor. Aranan kitap listenin başındaysa linear search tek karşılaştırmada biter: best case Θ(1). Son kitapta veya katalogda olmayan bir ISBN'de n karşılaştırma yapar: worst case Θ(n). Aranan kitap rastgele bir konumdaysa ortalama n/2 karşılaştırma yapar; sabiti atınca average case de Θ(n).
Production'da en çok worst case'e bakarız, çünkü SLA (Service Level Agreement) ihlali ortalama istekten değil en kötü istekten gelir. Dictionary<TKey, TValue>.ContainsKey buna iyi bir örnek. Microsoft dokümanı bu method'un "O(1)'e yaklaştığını" söyler. Bu bir average case ifadesi ve iyi dağılan bir GetHashCode varsayar. Bütün key'ler aynı hash'i üretirse her arama aynı bucket'taki zinciri baştan sona gezer ve worst case Θ(n)'e düşer. Bunu kötü bir GetHashCode ile serinin son yazısında ölçeceğiz. API (Application Programming Interface) complexity tablosunun tamamı için C# Koleksiyonlar serisindeki "C# Immutable Collection'lar ve Doğru Collection'ı Seçmek" yazısına bakabilirsin; burada tekrar etmiyorum.
Yaygın Büyüme Sınıfları
Gerçek kodun büyük çoğunluğu birkaç sınıftan birine düşer. Sezgi kazanmak için her sınıfın farklı n'lerde kaç adıma karşılık geldiğini hesaplatan küçük bir program yazdım:
         n   log2 n     n log2 n        n^2        2^n         n!
        10      3.3         33.2        100   1.02E+03   3.63E+06
        20      4.3         86.4        400   1.05E+06   2.43E+18
       100      6.6          664      1E+04   1.27E+30  9.33E+157
     1,000     10.0     9.97E+03      1E+06  1.07E+301   Infinity
 1,000,000     19.9     1.99E+07      1E+12   Infinity   Infinity
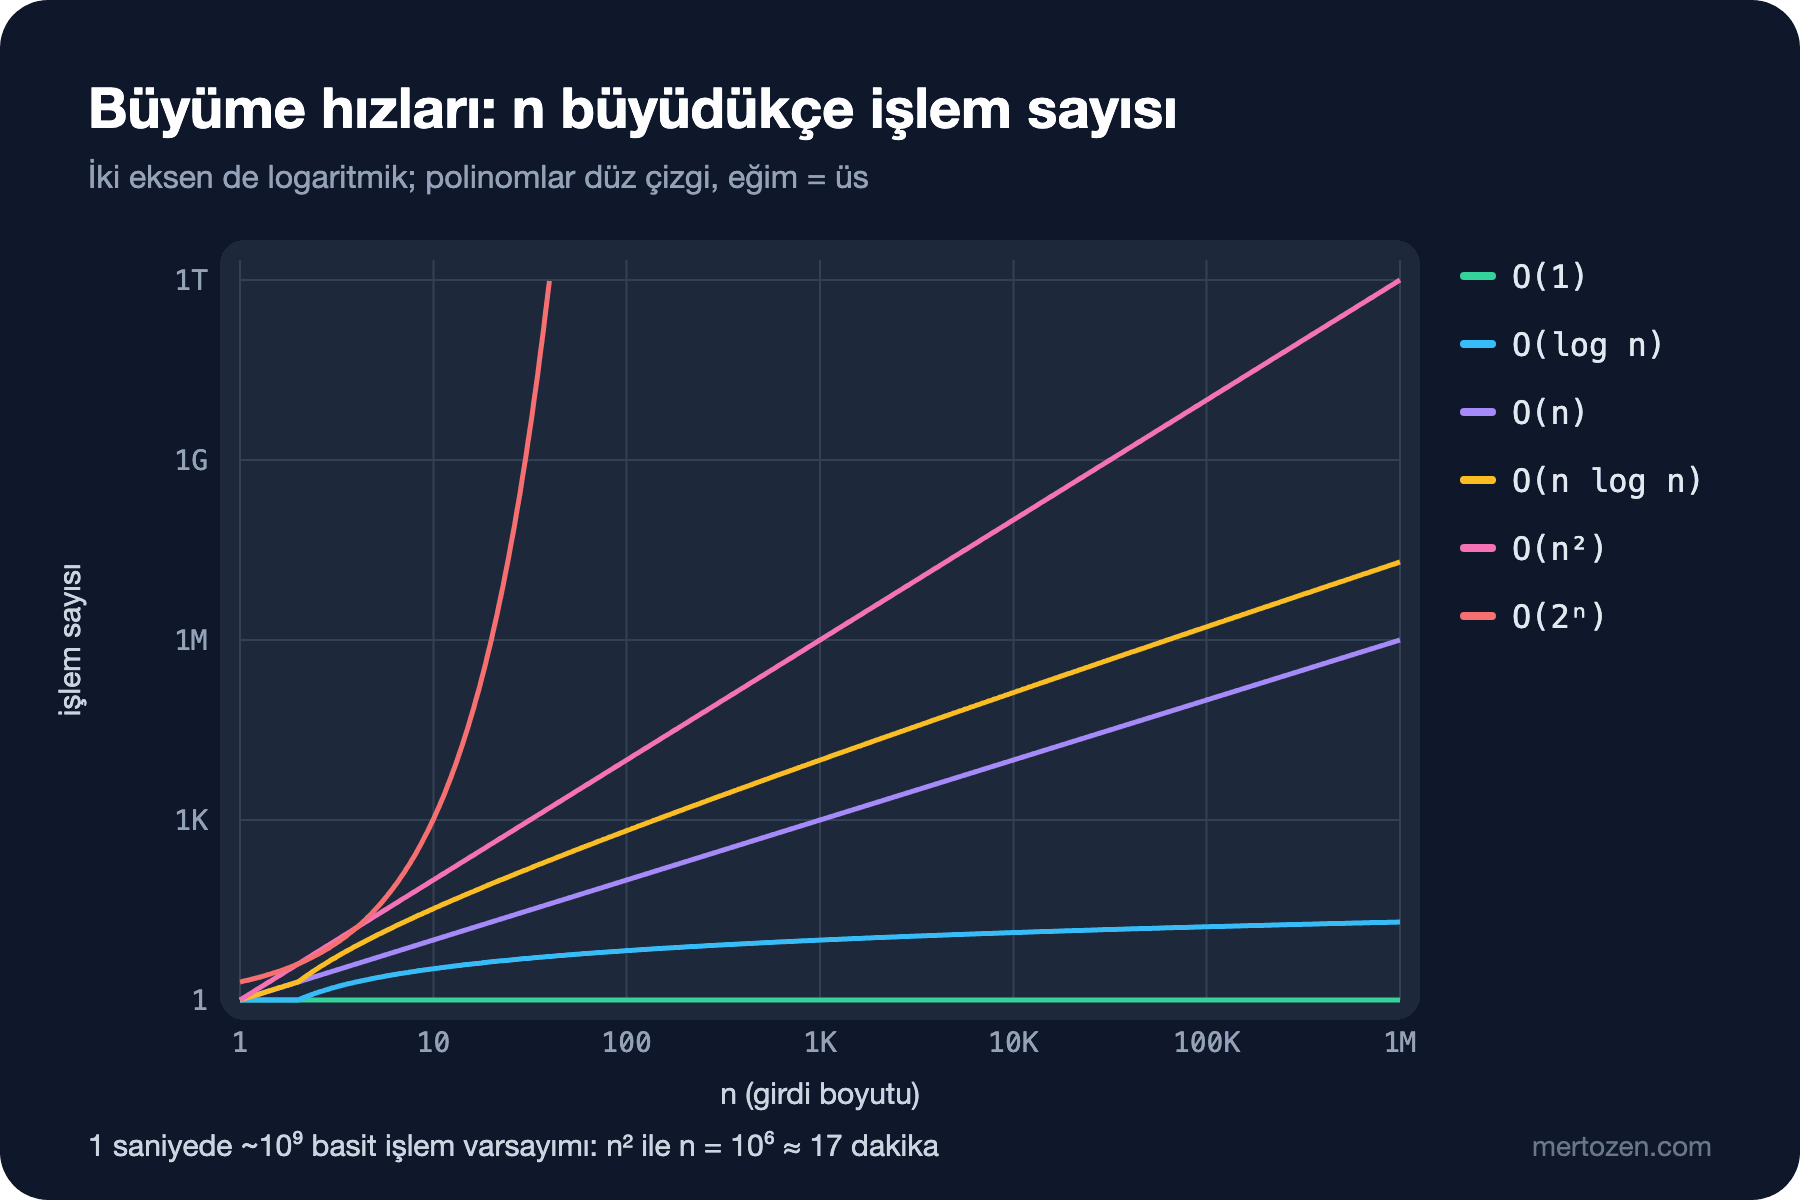
Infinity değerleri bir hata değil: 1.000! ve 2¹⁰⁰⁰⁰⁰⁰ bir double'ın tutabileceği en büyük değeri (yaklaşık 1,8 × 10³⁰⁸) aşıyor. Aşağıdaki grafik aynı sınıfları iki ekseni de logaritmik olarak çiziyor:
Bookstore'dan birer örnekle:
| Sınıf | Bookstore örneği | n iki katına çıkınca |
|---|---|---|
O(1) | Sepette index ile item okumak, HashSet araması (average) | değişmez |
O(log n) | Sıralı fiyat listesinde binary search | bir adım artar |
O(n) | Bütün siparişlerin toplamını almak | iki katı |
O(n log n) | Kataloğu başlığa göre sıralamak | iki katından biraz fazla |
O(n²) | Her kitabı her kitapla karşılaştırıp kopya aramak | dört katı |
O(2ⁿ) | n kitaplık bir kampanyanın bütün alt kümelerini denemek | karesi alınır |
O(n!) | n mağazayı dolaşan kuryenin bütün rotalarını denemek | n'e 1 eklemek bile (n+1) katı |
Grafiğin altındaki not kaba ama faydalı bir ölçü: saniyede yaklaşık 10⁹ basit işlem yapan bir çekirdek varsayarsan O(n²) bir algoritma n = 10⁶'da yaklaşık 17 dakika sürer, O(n log n) bir algoritma 20 milisaniye. O(2ⁿ) ise n = 50'de yaklaşık 13 güne, n = 60'ta 36 yıla çıkar.
Ölçmek: List, HashSet ve Binary Search
Tahmin bölümündeki soruya dönelim. BenchmarkDotNet ile üç aramayı 10, 1.000 ve 1.000.000 element üzerinde ölçtüm. Aranan key listenin son element'i, yani linear search için worst case:
[MemoryDiagnoser]
public class CatalogLookupBenchmarks
{
    private List<string> _list = [];
    private HashSet<string> _set = [];
    private string[] _sorted = [];
    private string _target = "";

    [Params(10, 1_000, 1_000_000)]
    public int N;

    [GlobalSetup]
    public void Setup()
    {
        _list = [.. Enumerable.Range(1, N).Select(CatalogFactory.IsbnOf)];
        _set = [.. _list];
        _sorted = [.. _list.Order(StringComparer.Ordinal)];
        _target = CatalogFactory.IsbnOf(N); // list için worst case: son element
    }

    [Benchmark(Baseline = true)]
    public bool ListContains() => _list.Contains(_target);

    [Benchmark]
    public bool HashSetContains() => _set.Contains(_target);

    [Benchmark]
    public bool SortedArrayBinarySearch() => Array.BinarySearch(_sorted, _target, StringComparer.Ordinal) >= 0;
}
Sonuç (Apple M5, macOS 27.0.1, .NET 10.0.13, Arm64 RyuJIT; tablo kısaltıldı):
| Method                  | N       | Mean             | Ratio |
|------------------------ |-------- |-----------------:|------:|
| ListContains            | 10      |        14.142 ns |  1.00 |
| HashSetContains         | 10      |         4.241 ns |  0.30 |
| SortedArrayBinarySearch | 10      |         9.926 ns |  0.70 |
| ListContains            | 1000    |     1,446.844 ns | 1.000 |
| HashSetContains         | 1000    |         5.035 ns | 0.003 |
| SortedArrayBinarySearch | 1000    |        26.687 ns | 0.018 |
| ListContains            | 1000000 | 1,390,590.370 ns | 1.002 |
| HashSetContains         | 1000000 |         4.476 ns | 0.000 |
| SortedArrayBinarySearch | 1000000 |        39.618 ns | 0.000 |
Teori ile ölçüm çok yakın. 1.000'den 1.000.000'a geçişte List.Contains 961 kat yavaşladı (bin katın hemen altı; büyük array'de ölçüm gürültüsü de var), binary search 1,48 kat yavaşladı (log₂ 10⁶ / log₂ 10³ = 2; fark sabit maliyetlerden), HashSet ise ölçüm hassasiyeti içinde hiç değişmedi. Üçü de hiç allocation yapmadı. Bu benchmark'ın nasıl kurulduğunu ve sonuç tablosunun sütunlarını C# İleri serisindeki "C#'ta Performans: Allocation, Struct'lar ve BenchmarkDotNet ile Ölçmek" yazısında anlatmıştık.
Üretimde Dikkat
Big-O bir tahmin aracı; asıl değeri, sorun çıkmadan önce "bu kod veri büyüyünce ne olur" sorusunu sordurması. Production'da birkaç alışkanlık bu soruyu somut tutar.
n'i loglarda görünür kıl. "Siparişleri eşleştirdim, 340 ms" logu az şey söyler. "orders=48.000, customers=1.200, 340 ms" logu ise iki hafta sonra aynı satır "orders=96.000, 1.350 ms" olduğunda büyümenin doğrusal değil karesel olduğunu sana söyler.
O(1)'in de bir girdisi var. Bu yazının başındaki ikinci soruyu ölçtüm. Bir HashSet<string>'te üç key var; aranan key'in uzunluğunu 13, 1.000 ve 100.000 karakter yaptım. Hash tablosunun boyutu değişmiyor, yani element sayısına göre arama O(1). Ama string'in hash'ini hesaplamak ve eşitliğini kontrol etmek her karakteri okur:
| Method          | KeyLength | Mean          |
|---------------- |---------- |--------------:|
| HashSetContains | 13        |      6.044 ns |
| HashSetContains | 1000      |    219.886 ns |
| HashSetContains | 100000    | 21,088.598 ns |
Key 100 kat uzayınca arama da yaklaşık 96 kat yavaşladı. Yani HashSet araması element sayısına göre O(1), key uzunluğu k'ye göre O(k). İki büyüklüğün ikisini de yazmak, n'i doğru seçmenin bir başka örneği.
Son olarak, büyüme sınıfı küçük n'de karar verdirmez. 10 element'lik ölçümde bile HashSet kazandı ama farkı birkaç nanosaniye; bu ölçekte okunabilirlik ve bellek daha önemli bir kriter olabilir. Big-O'nun asıl sesini yükselttiği yer, n'in bugün küçük ama yarın büyük olacağı yerler: kullanıcı başına değil sistem başına büyüyen listeler, her gün eklenen loglar, büyüyen kataloglar.
Sık Düşülen Tuzaklar
"O(1) her zaman hızlıdır." O(1) yalnızca "n'den bağımsız" demek. Sabit bir 50 milisaniyelik network çağrısı da O(1)'dir. Hash hesaplaması gibi gizli bir maliyet de yukarıda gördüğün gibi başka bir büyüklüğe bağlı olabilir.
"O(n²) her zaman yavaştır." n = 10'da 100 adım hiçbir şey değil. .NET'in kendi Array.Sort'u bile 16 ve daha az element'lik parçalarda O(n²) olan insertion sort kullanır, çünkü küçük n'de sabiti daha düşük.
Yanlış n. Döngü sayısını değil, gövdenin toplam çalışma sayısını say. İç içe iki döngü toplam element sayısı kadar iş yapabilir; tek bir satır LINQ (Language Integrated Query) çağrısı ise içinde bir döngü saklayabilir. Bir sonraki yazının konusu tam olarak bu.
Average case'i garanti sanmak. Dictionary ortalamada O(1). Saldırgan kontrollü key'ler veya kötü bir GetHashCode worst case'i production'a taşıyabilir.
Big-O'yu ölçümün yerine koymak. İki O(n) algoritmadan biri diğerinin on katı sürebilir. Analiz hangi algoritmanın ölçeklendiğini söyler; hangisinin bugün daha hızlı olduğunu ölçüm söyler.
Küçük Bir Deneme
★☆☆ CatalogSearch.Linear'ı 10.000 kitaplık bir katalogda, rastgele seçilmiş 1.000 ISBN için çalıştır ve ortalama karşılaştırma sayısını yazdır. Sonuç n/2'ye ne kadar yakın?
★★☆ T(n) = 5n log₂ n + 300n fonksiyonu için 5n log₂ n teriminin 300n'yi hangi n'de geçtiğini hesapla. Bu sınırın altında hangi terim baskın, ve bu, algoritmayı küçük katalogda ölçen birini nasıl yanıltır?
★★★ Yazarların ve kitaplarının olduğu bir Dictionary<string, List<Book>> kur; yazar sayısını sabit tutup toplam kitap sayısını iki katına çıkararak "her yazarın her kitabını gez" kodunun süresini BenchmarkDotNet ile ölç. Sonra kitap sayısını sabit tutup yazar sayısını artır. Hangi büyüklük süreyi belirliyor?
Bu yazıda maliyetin dilini öğrendik ama adım sayısını hep elle saydık. Bir sonraki yazıda bunu koddan doğrudan okumayı öğreneceğiz: ardışık ve iç içe döngüler, her adımda yarıya inen döngüler, recursion için recurrence yazmak ve LINQ'in tek satırda sakladığı gizli döngüler.