

AI Bot'larını Tanımak ve Yönetmek: Training, Search ve User-Fetch Ayrımı
AI bot'ları üç sınıftır: GPTBot ve ClaudeBot gibi training crawler'ları, OAI-SearchBot ve Claude-SearchBot gibi search bot'ları ve ChatGPT-User gibi kullanıcı isteğiyle gelen fetch'ler; training'e kapatıp alıntıya açık kalmak için yalnız ilk sınıfı engellersin. robots.txt senaryolarını RFC 9309 kurallarıyla doğruluyor, Google'ın snippet ve Search Console kontrollerini, mertozen.com'un robots.txt'ini ve log'da AI bot ayırmayı gösteriyoruz.
Sürüm notu: Bu yazı OpenAI, Anthropic, Perplexity ve Google'ın crawler dokümanlarının Kasım 2026 hâlini esas alır; kod örnekleri .NET 10 ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore'un içerik politikası kararı net: "Kitap incelemelerimiz AI (Artificial Intelligence, yapay zekâ) modellerini eğitmek için kullanılmasın, ama AI cevaplarında kaynak olarak görünmeye devam etsin." Ekipten biri robots.txt'in en altına tek bir group ekliyor: User-agent: * ve Disallow: /, en üstte de OAI-SearchBot için Allow: /. Sence bu dosya kararı uyguluyor mu? Peki bir kullanıcı ChatGPT'ye Bookstore'un bir linkini yapıştırıp "bu sayfanın kısa bir özetini çıkar" dediğinde, robots.txt bu isteği durdurur mu?
Üç Sınıf: Training, Search ve User-initiated Fetch
AI şirketlerinin bot'ları amaçlarına göre üç sınıfa ayrılıyor ve her operatör bunu kendi dokümanında açıkça yazıyor:
- Training: gelecekteki modellerin eğitim verisini toplar. OpenAI'da GPTBot, Anthropic'te ClaudeBot. Common Crawl'un CCBot'u birçok modelin eğitiminde kullanılan açık bir web arşivi topluyor. Google'da ayrı bir bot yok; Google-Extended, Googlebot'un topladığı içeriğin Gemini modellerinin eğitiminde ve Gemini Apps ile Vertex AI'daki grounding'de kullanılıp kullanılamayacağını belirleyen bir robots.txt token'ı.
- Search ve index: sorgu anında bulunacak sayfaların index'ini kurar. OpenAI'da OAI-SearchBot (OAI, OpenAI'ın kısaltması), Anthropic'te Claude-SearchBot, Perplexity'de PerplexityBot; Google ve Microsoft tarafında Googlebot ve Bingbot.
- User-initiated fetch: bir kullanıcının isteği üzerine tek bir sayfayı o anda getirir. OpenAI'da ChatGPT-User, Anthropic'te Claude-User, Perplexity'de Perplexity-User.
Üçüncü sınıfın robots.txt ilişkisi en çok gözden kaçan nokta. OpenAI, ChatGPT-User'ın aksiyonları kullanıcı tarafından başlatıldığı için robots.txt kurallarının "geçerli olmayabileceğini" yazıyor. Perplexity, Perplexity-User'ın isteği bir kullanıcı yaptığı için robots.txt kurallarını "genellikle yok saydığını" söylüyor. Anthropic ise bot'larının robots.txt'e uyduğunu, Claude-User'ı engellemenin kullanıcı yönlendirmeli web aramasında görünürlüğü azaltabileceğini yazıyor. Baştaki ikinci sorunun cevabı bu yüzden "operatöre göre değişir": robots.txt bu sınıf için garanti bir fren değil.
Bu üç sınıf log'da da farklı görünür. Training ve search bot'ları sitemap'i ve çok sayıda sayfayı düzenli aralıklarla tarar. User-initiated fetch ise tek bir sayfaya, bir kullanıcının o anki sorusuyla gelir; bu yüzden log'daki her ChatGPT-User veya Claude-User isteği, arkasında gerçek bir insanın sitenle ilgili bir şey sorduğu anlamına gelir. Serinin ölçüm yazısında bu farkı, AI görünürlüğünün en dolaysız sinyallerinden biri olarak kullanacağız.
Kontroller ve Neyi Etkiledikleri
Elindeki kontroller yalnızca robots.txt değil ve her biri farklı bir sınıfı etkiliyor:
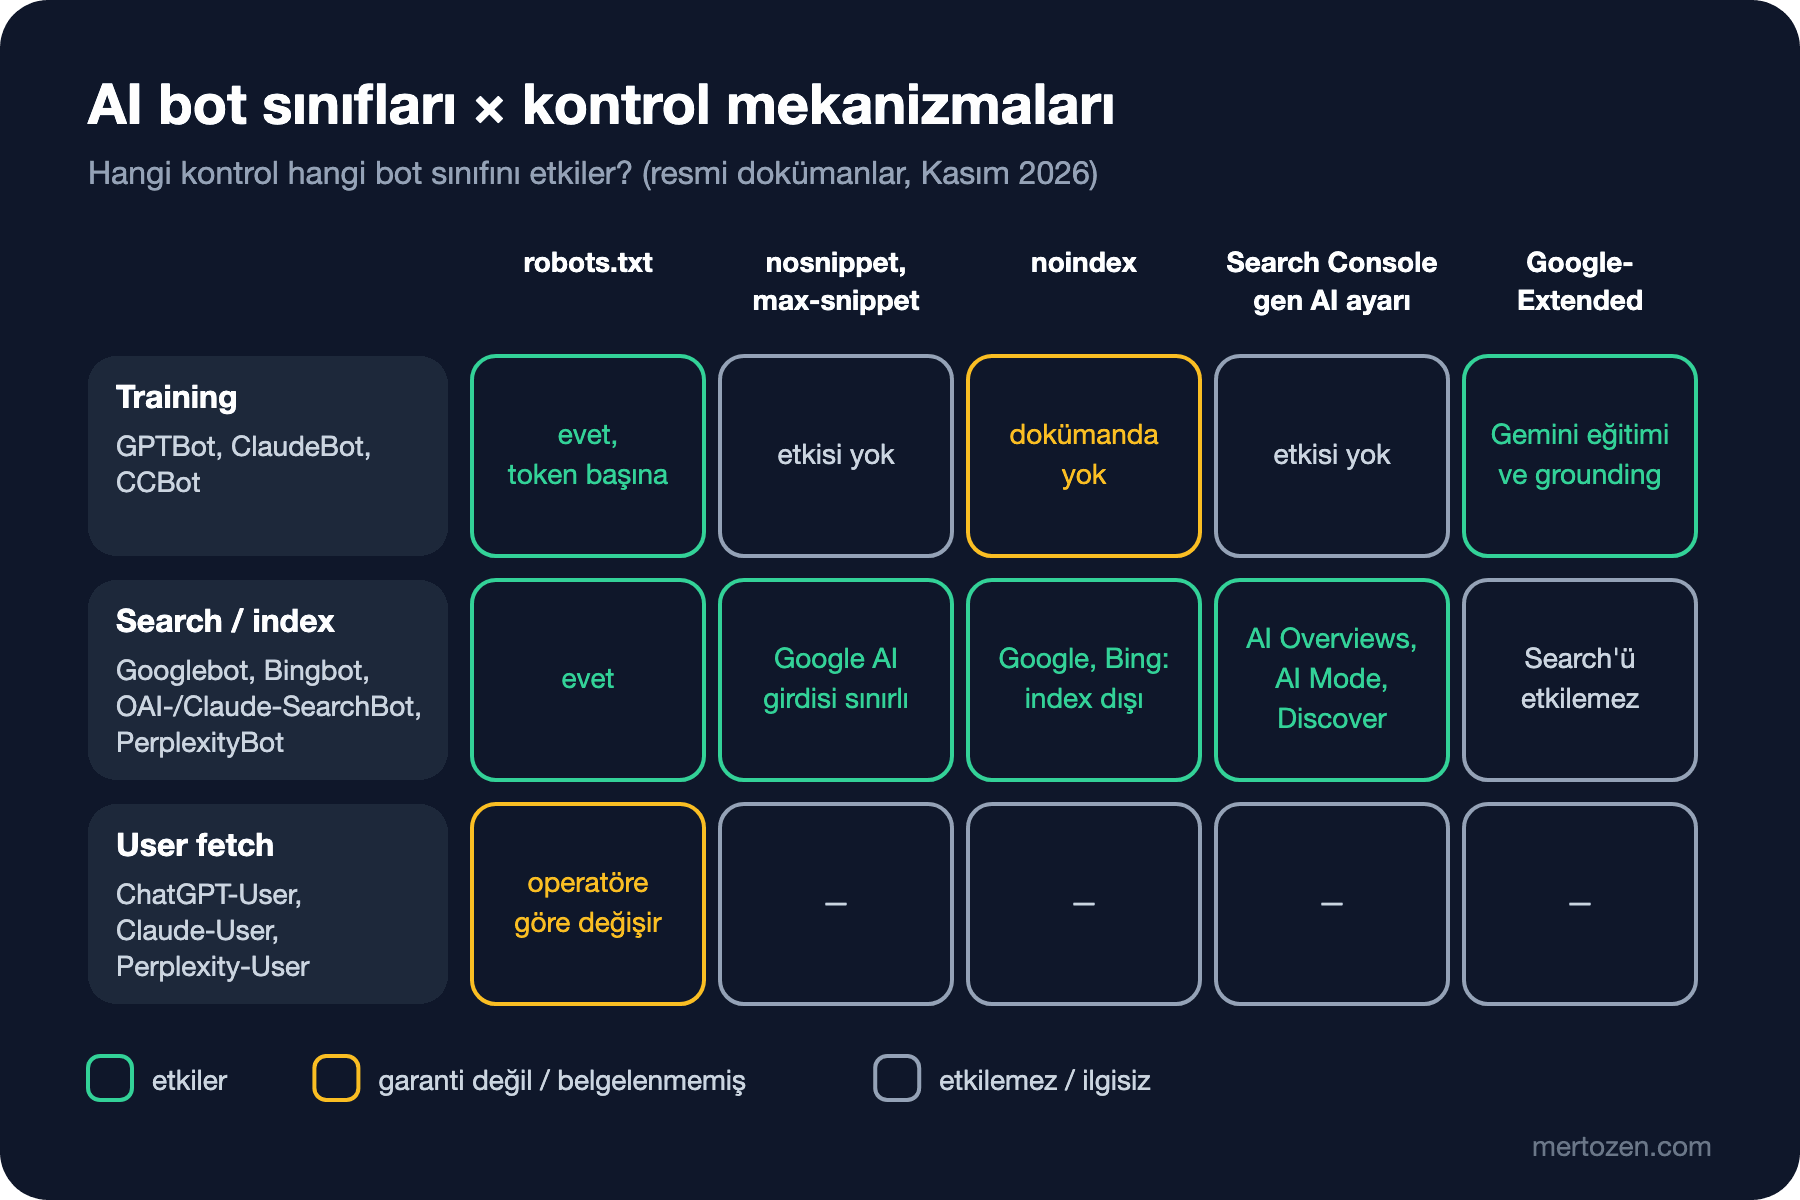
robots.txt, token başına çalışan tek ortak mekanizma. Robots.txt'in kendi kuralları, yani group'lar, en spesifik eşleşme ve hata durumları, Teknik SEO (Search Engine Optimization) serisinin "robots.txt Rehberi" yazısında; burada yalnızca AI bot'larına özgü kısma bakıyoruz.
Snippet kontrolleri Google'a özgü. Google'ın robots meta tag dokümanına göre nosnippet içeriğin AI Overviews ve AI Mode'a doğrudan girdi olarak kullanılmasını engelliyor, max-snippet ise ne kadarının kullanılabileceğini sınırlıyor; data-nosnippet sayfanın bir bölümünü dışarıda bırakıyor. noindex sayfayı Google ve Bing index'inden çıkarıyor ve dolayısıyla bu index'lere dayanan AI cevaplarından da. Diğer operatörlerin dokümanlarında bu meta kurallar için bir taahhüt yok.
Search Console'daki "Search generative AI" kontrolü Haziran 2026'da geldi ve 31 Ağustos 2026 itibarıyla bütün sitelerde. Site seviyesinde çalışıyor ve AI Overviews, AI Mode ve Discover'daki generative AI özelliklerini kapsıyor. Kapatan siteler bu özelliklerden trafik ve impression almıyor; Google bu kontrolün bu özelliklerin dışındaki arama sonuçları için ranking sinyali olarak kullanılmayacağını yazıyor.
Google-Extended ise ayrı bir eksen. Google'ın crawler sayfasına göre Google-Extended'ın ayrı bir user agent'ı yok, Google Search'e dahil edilmeyi etkilemiyor ve ranking sinyali değil. Yani Google-Extended'ı kapatmak seni AI Overviews'tan çıkarmaz; AI Overviews'tan çıkmanın yolu Search Console kontrolü veya snippet kuralları.
Bir de ufukta olan var: Google 30 Ekim 2026'da, IETF (Internet Engineering Task Force) AIPREF (AI Preferences) çalışma grubunun önerisine dayanan ve robots.txt içinde birden fazla sağlayıcı için ortak bir training tercihi bildiren bir "policy token"ı diğer AI sağlayıcılarıyla birlikte 2027'de desteklemeyi hedeflediğini duyurdu. Google-Extended açıkça belirtilmemişse bu token'daki training opt-out'u Google-Extended'ı engellemek gibi yorumlayacak. Anthropic'in dokümanı da ClaudeBot'u doğrudan adlandıran kuralların genel bir "AI training'e hayır" sinyalinin önüne geçtiğini yazıyor. Sözdizimi henüz taslak olduğu için burada örnek vermiyorum.
Karar Matrisi: robots.txt ile Senaryolar
Bookstore'un kararını uygulayan robots.txt şöyle. Training token'ları bir group'ta toplanıyor, geri kalan herkes, search bot'ları dahil, * group'una düşüyor:
# training crawler'ları: hayır
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
Disallow: /

# search crawler'ları dahil diğer herkes: evet, özel alanlar hariç
User-agent: *
Disallow: /account/
Allow: /
Dosyanın gerçekte ne söylediğini, RFC (Request for Comments) 9309'un group seçme ve en uzun eşleşme kurallarını uygulayan küçük bir .NET 10 file-based app ile kontrol ettim:
using Rule = (bool Allow, string Path);
using Group = (string Agent, System.Collections.Generic.List<(bool Allow, string Path)> Rules);

string[] lines = File.ReadAllLines(args[0]);
string[] bots = ["Googlebot", "Bingbot", "OAI-SearchBot", "Claude-SearchBot", "PerplexityBot",
                 "GPTBot", "ClaudeBot", "CCBot", "Google-Extended"];
string[] paths = ["/books/async-in-practice", "/account/orders"];

Console.WriteLine($"{"token",-18}{paths[0],-28}{paths[1]}");
foreach (string bot in bots)
{
    string[] verdicts = [.. paths.Select(p => IsAllowed(lines, bot, p) ? "allow" : "DISALLOW")];
    Console.WriteLine($"{bot,-18}{verdicts[0],-28}{verdicts[1]}");
}

// RFC 9309 kısaca: bu token'ı adlandıran group(lar), yoksa "*";
// en uzun eşleşen path kazanır, eşitlikte Allow kazanır. Wildcard yok.
static bool IsAllowed(string[] lines, string token, string path)
{
    List<Group> groups = [];
    List<Rule>? rules = null;
    bool lastWasAgent = false;
    foreach (string raw in lines)
    {
        string line = raw.Split('#')[0].Trim();
        int colon = line.IndexOf(':');
        if (colon < 0)
        {
            continue;
        }
        string key = line[..colon].Trim().ToLowerInvariant();
        string value = line[(colon + 1)..].Trim();
        if (key == "user-agent")
        {
            if (!lastWasAgent)
            {
                rules = [];
            }
            groups.Add((value.ToLowerInvariant(), rules!));
            lastWasAgent = true;
        }
        else if (key is "allow" or "disallow" && rules is not null)
        {
            rules.Add((key == "allow", value));
            lastWasAgent = false;
        }
    }

    List<Group> named = [.. groups.Where(g => g.Agent == token.ToLowerInvariant())];
    List<Group> chosen = named.Count > 0 ? named : [.. groups.Where(g => g.Agent == "*")];
    Rule match = chosen.SelectMany(g => g.Rules)
        .Where(r => r.Path.Length > 0 && path.StartsWith(r.Path))
        .OrderByDescending(r => r.Path.Length).ThenByDescending(r => r.Allow)
        .FirstOrDefault();
    return match == default || match.Allow;
}
$ dotnet run RobotsMatrix.cs -- ai-robots.txt
token /books/async-in-practice /account/orders
Googlebot allow DISALLOW
Bingbot allow DISALLOW
OAI-SearchBot allow DISALLOW
Claude-SearchBot allow DISALLOW
PerplexityBot allow DISALLOW
GPTBot DISALLOW DISALLOW
ClaudeBot DISALLOW DISALLOW
CCBot DISALLOW DISALLOW
Google-Extended DISALLOW DISALLOWMatris tam istenen şey: search bot'ları kitap sayfasına erişiyor, training token'ları hiçbir yere erişemiyor. Baştaki ilk sorunun cevabı da buradan çıkıyor. User-agent: * ve Disallow: / yazıp yalnızca OAI-SearchBot'u açmak, kendi group'u olmayan Googlebot, Bingbot, Claude-SearchBot ve PerplexityBot'u da kapatır; RFC 9309'a göre bir crawler kendi adını taşıyan group yoksa * group'unu kullanır. Bu, Google'dan ve Bing'den, dolayısıyla AI Overviews ve Copilot'tan çıkmak demek.
Diğer iki uç senaryo daha basit. Her şeye açık bir site için User-agent: * ve Allow: / yeterli; AI bot'ları için ayrıca Allow yazmak davranışı değiştirmez. "Hiçbir AI ürününde görünmek istemiyorum" kararı ise search bot'larını da kapatmayı gerektirir ve OpenAI'ın notuna göre OAI-SearchBot'tan çıkan siteler ChatGPT'de yine de navigational link olarak görünebilir. Bu kararlar teknik değil, içerik politikası kararları.
mertozen.com'un robots.txt'i
Bu sitenin robots.txt'i SeoController'da kodla üretiliyor ve şöyle:
User-agent: *
Allow: /

User-agent: GPTBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: CCBot
Allow: /

Sitemap: https://www.mertozen.com/sitemap.xml
Aynı araçla çalıştırınca bütün token'lar için iki path'te de sonuç allow. Bu dosya üç şey söylüyor. Birincisi, beş ayrı Allow group'u bugünkü davranışı değiştirmiyor; * zaten her şeye izin veriyor. Tek etkileri, ileride * group'una bir Disallow eklenirse bu beş token'ın o kuraldan etkilenmemesi. İkincisi, OAI-SearchBot ve Claude-SearchBot'un kendi group'u yok; * kuralıyla açıklar. Üçüncüsü, koddaki yorum bu Allow'ların gerekçesini "içeriğin üretken AI motorlarında alıntılanması" olarak veriyor. Oysa adı geçen beşten dördü, GPTBot, ClaudeBot, CCBot ve Google-Extended, training token'ları; PerplexityBot ise search tarafında. Alıntılanmayı belirleyen bot'lar ayrı. Sitenin eğitime açık kalması bilinçli bir tercih olabilir; ama gerekçe ile mekanizmanın örtüşmesi için yorumun güncellenmesi ya da group'ların sadeleştirilmesi temiz bir adım. Karar site sahibinin.
Log'dan AI Bot Trafiğini Ayırmak
Kararın etkisini görmek için hangi bot'un siteye ne zaman geldiğini bilmen gerekiyor. Bookstore'a, operatörlerin dokümanlarındaki token'ları amaçlarıyla eşleyen bir sınıflandırıcı ve onu kullanan bir middleware ekledim:
namespace Bookstore.Web.Seo;

public enum AiBotPurpose { Training, Search, UserFetch }

public sealed record AiBot(string Token, string Operator, AiBotPurpose Purpose);

public static class AiBots
{
    // token'lar ve amaçlar, her operatörün kendi dokümanındaki gibi (2026-11)
    private static readonly AiBot[] Known =
    [
        new("GPTBot", "OpenAI", AiBotPurpose.Training),
        new("OAI-SearchBot", "OpenAI", AiBotPurpose.Search),
        new("ChatGPT-User", "OpenAI", AiBotPurpose.UserFetch),
        new("ClaudeBot", "Anthropic", AiBotPurpose.Training),
        new("Claude-SearchBot", "Anthropic", AiBotPurpose.Search),
        new("Claude-User", "Anthropic", AiBotPurpose.UserFetch),
        new("PerplexityBot", "Perplexity", AiBotPurpose.Search),
        new("Perplexity-User", "Perplexity", AiBotPurpose.UserFetch),
        new("CCBot", "Common Crawl", AiBotPurpose.Training),
    ];

    public static AiBot? Match(string? userAgent) =>
        string.IsNullOrEmpty(userAgent)
            ? null
            : Known.FirstOrDefault(b => userAgent.Contains(b.Token, StringComparison.OrdinalIgnoreCase));
}
namespace Bookstore.Web.Seo;
public sealed class AiTrafficMiddleware(RequestDelegate next, ILogger<AiTrafficMiddleware> logger)
{
public async Task InvokeAsync(HttpContext context)
{
await next(context);
AiBot? bot = AiBots.Match(context.Request.Headers.UserAgent);
if (bot is not null)
{
logger.LogInformation("AI bot {Token} ({Purpose}, {Operator}) {Method} {Path} -> {Status}",
bot.Token, bot.Purpose, bot.Operator, context.Request.Method,
context.Request.Path, context.Response.StatusCode);
}
}
}Yerel uygulamaya, dokümanlardaki user agent string'leriyle curl -A istekleri gönderdim; son istek normal bir tarayıcı user agent'ıyla. Log'a düşen satırlar:
info: Bookstore.Web.Seo.AiTrafficMiddleware[0] AI bot GPTBot (Training, OpenAI) GET /books/async-in-practice -> 200
info: Bookstore.Web.Seo.AiTrafficMiddleware[0] AI bot OAI-SearchBot (Search, OpenAI) GET /books/async-in-practice -> 200
info: Bookstore.Web.Seo.AiTrafficMiddleware[0] AI bot ChatGPT-User (UserFetch, OpenAI) GET /books/async-in-practice -> 200
info: Bookstore.Web.Seo.AiTrafficMiddleware[0] AI bot PerplexityBot (Search, Perplexity) GET /books/async-in-practice -> 200
info: Bookstore.Web.Seo.AiTrafficMiddleware[0] AI bot Perplexity-User (UserFetch, Perplexity) GET /books/async-in-practice -> 200
info: Bookstore.Web.Seo.AiTrafficMiddleware[0] AI bot PerplexityBot (Search, Perplexity) GET /account/orders -> 404
Tarayıcı isteği log'a düşmedi. Son satır ise önemli bir hatırlatma: robots.txt /account/'u engellese de istek sunucuya ulaştı, çünkü robots.txt bir erişim kontrolü değil, bot'un uymayı taahhüt ettiği bir rica. Gerçekten korunması gereken alanlar authentication ister. Bir de user agent kolayca taklit edilebilir; bir isteğin gerçekten iddia ettiği bot'tan geldiğini doğrulamak için operatörlerin yayımladığı IP (Internet Protocol) aralıklarına bakmak gerekiyor: OpenAI her bot için ayrı bir JSON (JavaScript Object Notation) dosyası, Anthropic ve Perplexity de kendi listelerini yayımlıyor. Googlebot için reverse DNS (Domain Name System) doğrulaması ve büyük log dosyalarını tarayan araç Teknik SEO serisinin "Crawl Budget, Log Analizi ve Googlebot'u Doğrulamak" yazısında; aynı yaklaşım AI bot'larına da uygulanabilir.
Üretimde Dikkat
Değişikliklerin etkisi anında değil. OpenAI robots.txt değişikliğinin search sistemlerine yansımasının yaklaşık 24 saat sürebileceğini yazıyor; Google tarafında ise önizleme kontrollerinin etkisi yeniden crawl'a bağlı ve günlerden aylara kadar sürebiliyor.
robots.txt'i her ortamda aynı kodla üret ama içeriğini ortama göre değiştir; staging'in robots.txt'i production'a sızmasın. Ortama göre robots.txt üreten endpoint Teknik SEO serisinde.
Kararı yazılı tut. Training'e kapatma ile alıntıya açık kalma bir içerik politikası; neden alındığını ve hangi token'larla uygulandığını bir karar kaydına yaz, yeni bir bot çıktığında listeyi oradan güncelle.
Sık Düşülen Tuzaklar
User-agent: * ile her şeyi kapatıp istediklerini tek tek açmak. Listede unuttuğun her search bot'u, Googlebot dahil, kapalı kalır.
Google-Extended'ı kapatınca AI Overviews'tan çıkacağını sanmak. Google-Extended Search'ü etkilemez; Google'ın AI özellikleri için doğru araç Search Console kontrolü ve snippet kuralları.
User-initiated fetch'leri robots.txt ile durdurabileceğini varsaymak. OpenAI ve Perplexity bu sınıf için robots.txt'in uygulanmayabileceğini açıkça yazıyor.
User agent'a körü körüne güvenmek. Analiz ve özellikle engelleme kararları için IP doğrulaması şart.
Küçük Bir Deneme
★☆☆ Kendi sitenin robots.txt'ini RobotsMatrix.cs ile çalıştır ve sonucu sitenin içerik politikasıyla karşılaştır. Beklemediğin bir DISALLOW veya allow var mı?
★★☆ Araca * wildcard'ı ve $ desteği ekle, ardından Disallow: /*?sort= gibi bir kuralın hangi bot'ları hangi URL'lerde (Uniform Resource Locator) etkilediğini matris olarak göster.
★★★ AiBots.Match'i IP doğrulamasıyla genişlet: OpenAI'ın yayımladığı JSON dosyasını uygulama açılırken indirip cache'le, isteğin IP'si listede değilse bot'u "unverified" olarak logla. Testte JSON'u yerel bir dosyadan oku.
Bot'ları ve kontrolleri gördük. Bir sonraki yazıda soruyu tersine çeviriyoruz: bot sayfaya ulaştıktan sonra içeriğin alıntılanma ihtimalini ne artırıyor? Araştırmaların gerçekte ne gösterdiğine bakacağız.