

Redis'te Replication, Sentinel ve Cluster: Failover, Hash Slot'lar, Hash Tag ve CROSSSLOT
Redis replication asenkron olduğu için client'a onaylanmış bir yazma failover'da kaybolabilir; WAIT bunu önlemez, yalnız görünür yapar. Gerçek çıktılarla kaybolan sipariş numarası, Sentinel ve StackExchange.Redis ile failover süresi, Cluster'da 16384 hash slot, MOVED, CROSSSLOT ve hash tag, her primary'ye yüklenmesi gereken Functions, node'a özel keyspace notification'lar, Redis 8.4'ün atomic slot migration'ı ve Valkey 9 farkları.
Sürüm notu: Bu yazıdaki örnekler Redis 8.10.3 (redis:8), Valkey 9.1.3, .NET 10 ve StackExchange.Redis 3.4.35 ile çalıştırılmıştır.
Önce Tahmin Et
Bookstore (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) sipariş numaralarını Redis'teki bir sayaçtan alıyor. lab/sentinel'daki container'da bir primary (6390), onun bir replica'sı (6391) ve üç Sentinel çalışıyor. Primary iki sipariş numarası veriyor ve her seferinde WAIT 1 1000 ile "en az bir replica bu yazmayı aldı mı, 1 saniye bekle" diye soruyor. İkinci numaradan önce replica'nın bağlantısı kopuyor (bir ağ sorunu gibi), ikinci numaradan sonra da primary çöküyor ve Sentinel replica'yı yeni primary yapıyor:
$ INCR bookstore:order:id-seq
1
$ WAIT 1 1000
1
replica stopped
ok
$ INFO replication (primary)
connected_slaves:0
$ INCR bookstore:order:id-seq
2
$ WAIT 1 1000
0
$ SHUTDOWN NOSAVE (primary)
replica resumed
failover after ~6s: primary is now 6391
Uygulama 2 numaralı siparişi müşteriye onayladı. Yeni primary'de GET bookstore:order:id-seq ne döner? Bir sonraki INCR hangi numarayı verir?
$ GET bookstore:order:id-seq (new primary)
1
Yeni primary 1 diyor: 2 numaralı sipariş hiç replica'ya ulaşmadı ve primary ile birlikte kayboldu. Bir sonraki sipariş yine 2 numarasını alacak; aynı numaralı iki sipariş. Redis'in replication'ı asenkron: primary yazmayı uygular, client'a cevap verir, replica'ya sonra gönderir. Bu yazıda bunun sonuçlarını anlatıyoruz: replication ve WAIT, Sentinel ile otomatik failover, Cluster'da hash slot'lar, MOVED, CROSSSLOT ve hash tag'ler, cluster'da pub/sub ve Functions, failover sırasında client'ın gördükleri ve Valkey farkları.
Replication: Asenkron Kopya, WAIT ve Kaybolan Yazma
Replica, primary'ye bağlanıp önce verinin tamamını bir RDB (Redis'in snapshot dosya formatı) dosyası olarak, sonra her yazma komutunu bir akış olarak alır. Önce Tahmin Et'te replica'nın kopmasını şöyle canlandırdım: primary'de replica'nın output buffer sınırını 1 MB'a indirdim (CONFIG SET client-output-buffer-limit "replica 1mb 0 0"), replica process'ini kill -STOP ile durdurdum ve 8 MB'lık bir rapor key'i yazdım. Primary'nin log'unda replica bağlantısının scheduled to be closed ASAP for overcoming of output buffer limits ile kapatıldığı görülüyor; 09'da yavaş subscriber'ı düşüren mekanizmanın aynısı. Sonraki yazma yalnız primary'de kaldı.
WAIT numreplicas timeout bu riski ortadan kaldırmaz, görünür yapar: son yazmayı kaç replica'nın onayladığını döndürür. 0 dönmesi yazmanın geri alındığı anlamına gelmez; primary'de duruyor, yalnız kopyası yok. Önemli bir sipariş için WAIT sonucuna göre "kaydedildi" demeden önce bir kez daha denemek ya da kalıcı kaydı SQL Server'a bırakmak mümkün. Primary tarafında min-replicas-to-write ve min-replicas-max-lag ayarları, yeterli sayıda güncel replica yoksa yazmaları reddettirebiliyor; kayıp penceresini daraltır ama kapatmaz. Leader-based replication'ın genel tablosu Distributed Systems Temelleri serisinin "Replication: Leader-Based, Multi-Leader, Leaderless ve Quorum" yazısında.
03'te sözünü ettiğimiz replica'da expiration davranışı da bu akıştan geliyor: replica süresi dolan key'leri kendisi silmez, primary'nin göndereceği DEL'i bekler. Primary'de 100.000 doğrulama kodunu 1 saniye TTL (key'in yaşam süresi) ile yazıp (primary'de hz 1 ile active expire'ı yavaşlatarak) 1,1 saniye sonra replica'ya baktım:
replica DBSIZE 1473, RANDOMKEY bookstore:verify:857, GET '', EXISTS 0, primary DBSIZE 1473
replica DBSIZE 0
Replica 1.473 key'i hâlâ sayıyor ve RANDOMKEY onlardan birini döndürüyor, ama GET boş, EXISTS 0: Redis 3.2'den beri replica, süresi geçmiş bir key'i okumada yok sayıyor. Primary'nin DEL'leri gelince sayı 0'a indi. DBSIZE ya da INFO keyspace ile replica'da sayım yapan bir monitoring script'i bu yüzden primary'den farklı sonuç görebilir.
Sentinel ile Otomatik Failover
Sentinel, primary'yi izleyen ayrı process'ler. Bir Sentinel primary'ye down-after-milliseconds (lab'da 5000) boyunca ulaşamazsa onu kendi gözünde düşmüş sayar (+sdown); quorum kadar Sentinel aynı fikre varınca (+odown) içlerinden biri replica'yı primary yapar ve client'lara yeni adresi duyurur (+switch-master). Lab'daki tek container'da iki Redis ve üç Sentinel var; production'da bunların her biri ayrı makinede olmalı, yoksa makine gidince Sentinel'ler de gider. Önce Tahmin Et'teki failover'ın Sentinel log'u:
26:X 14 Nov 2026 12:03:24.210 # +sdown master bookstore 127.0.0.1 6390
26:X 14 Nov 2026 12:03:25.316 # +odown master bookstore 127.0.0.1 6390 #quorum 3/2
26:X 14 Nov 2026 12:03:25.414 # +switch-master bookstore 127.0.0.1 6390 127.0.0.1 6391
StackExchange.Redis'te Sentinel'e bağlanmak için connection string'e Sentinel adreslerini ve izlenen servisin adını veriyorsun; multiplexer primary'yi Sentinel'den öğreniyor ve +switch-master'da yeni primary'ye geçiyor:
await using ConnectionMultiplexer mux = await ConnectionMultiplexer.ConnectAsync(
    "localhost:26379,localhost:26380,localhost:26381,serviceName=bookstore,abortConnect=false");
Lab'ı sıfırdan başlatıp her 100 ms'de bir INCR gönderen bir döngü çalıştırdım ve 5. saniyede primary'yi SHUTDOWN NOSAVE ile kapattım:
docker compose -f lab/sentinel/compose.yaml up -d
dotnet run --project src/Bookstore.RedisLab -- sentinel-failover 25
# başka bir terminalde, 5 saniye sonra:
docker compose -f lab/sentinel/compose.yaml exec sentinel redis-cli -p 6390 SHUTDOWN NOSAVE
4.6s first failure: RedisConnectionException: SocketClosed on 127.0.0.1:6390/Interactive
4.6s event ConnectionFailed 127.0.0.1:6390 Interactive SocketClosed
4.6s event ConnectionFailed 127.0.0.1:6390 Subscription SocketClosed
10.0s event ConnectionFailed 127.0.0.1:6391 Interactive SocketClosed
10.0s event ConnectionFailed 127.0.0.1:6391 Subscription SocketClosed
10.0s event ConnectionRestored 127.0.0.1:6391 Interactive
10.0s event ConnectionRestored 127.0.0.1:6391 Subscription
10.1s writes succeed again (primary for slot of bookstore:order:id-seq: 127.0.0.1:6391)
25.1s done: 189 writes ok, 2 failedYazmalar 5,4 saniye durdu, ama yalnız 2'si hata aldı. Bağlantı yokken StackExchange.Redis komutları bir backlog'da tutuyor ve bağlantı gelince gönderiyor; döngü bu sürede bekledi. 6391'in de bir kez SocketClosed vermesi Sentinel'in işi: Redis kaynak kodundaki açıklamaya göre Sentinel bir instance'ı yeniden yapılandırırken (REPLICAOF NO ONE dahil) aynı transaction'da bütün client bağlantılarını kapatıyor, client'lar yeniden bağlanıp yeni rolü öğreniyor. Uygulamanın görmesi gereken şey bu: failover saniyeler sürer, bu sürede istekler ya bekler ya hata alır; timeout ve retry ayarları bu süreye göre seçilmeli (14'te timeout mesajını okuyoruz).
Cluster: 16384 Hash Slot
Sentinel yüksek erişilebilirlik sağlar ama veri tek bir primary'nin belleğine sığmak zorunda. Cluster veriyi primary'ler arasında böler: key alanı 16384 hash slot'a ayrılmış, her primary bir slot aralığının sahibi, her primary'nin bir replica'sı var. Slot, key'in CRC16 (16 bitlik bir checksum algoritması) değerinin 16384'e bölümünden kalan; key'de süslü parantez varsa yalnız parantezin içi hesaba katılıyor (hash tag).
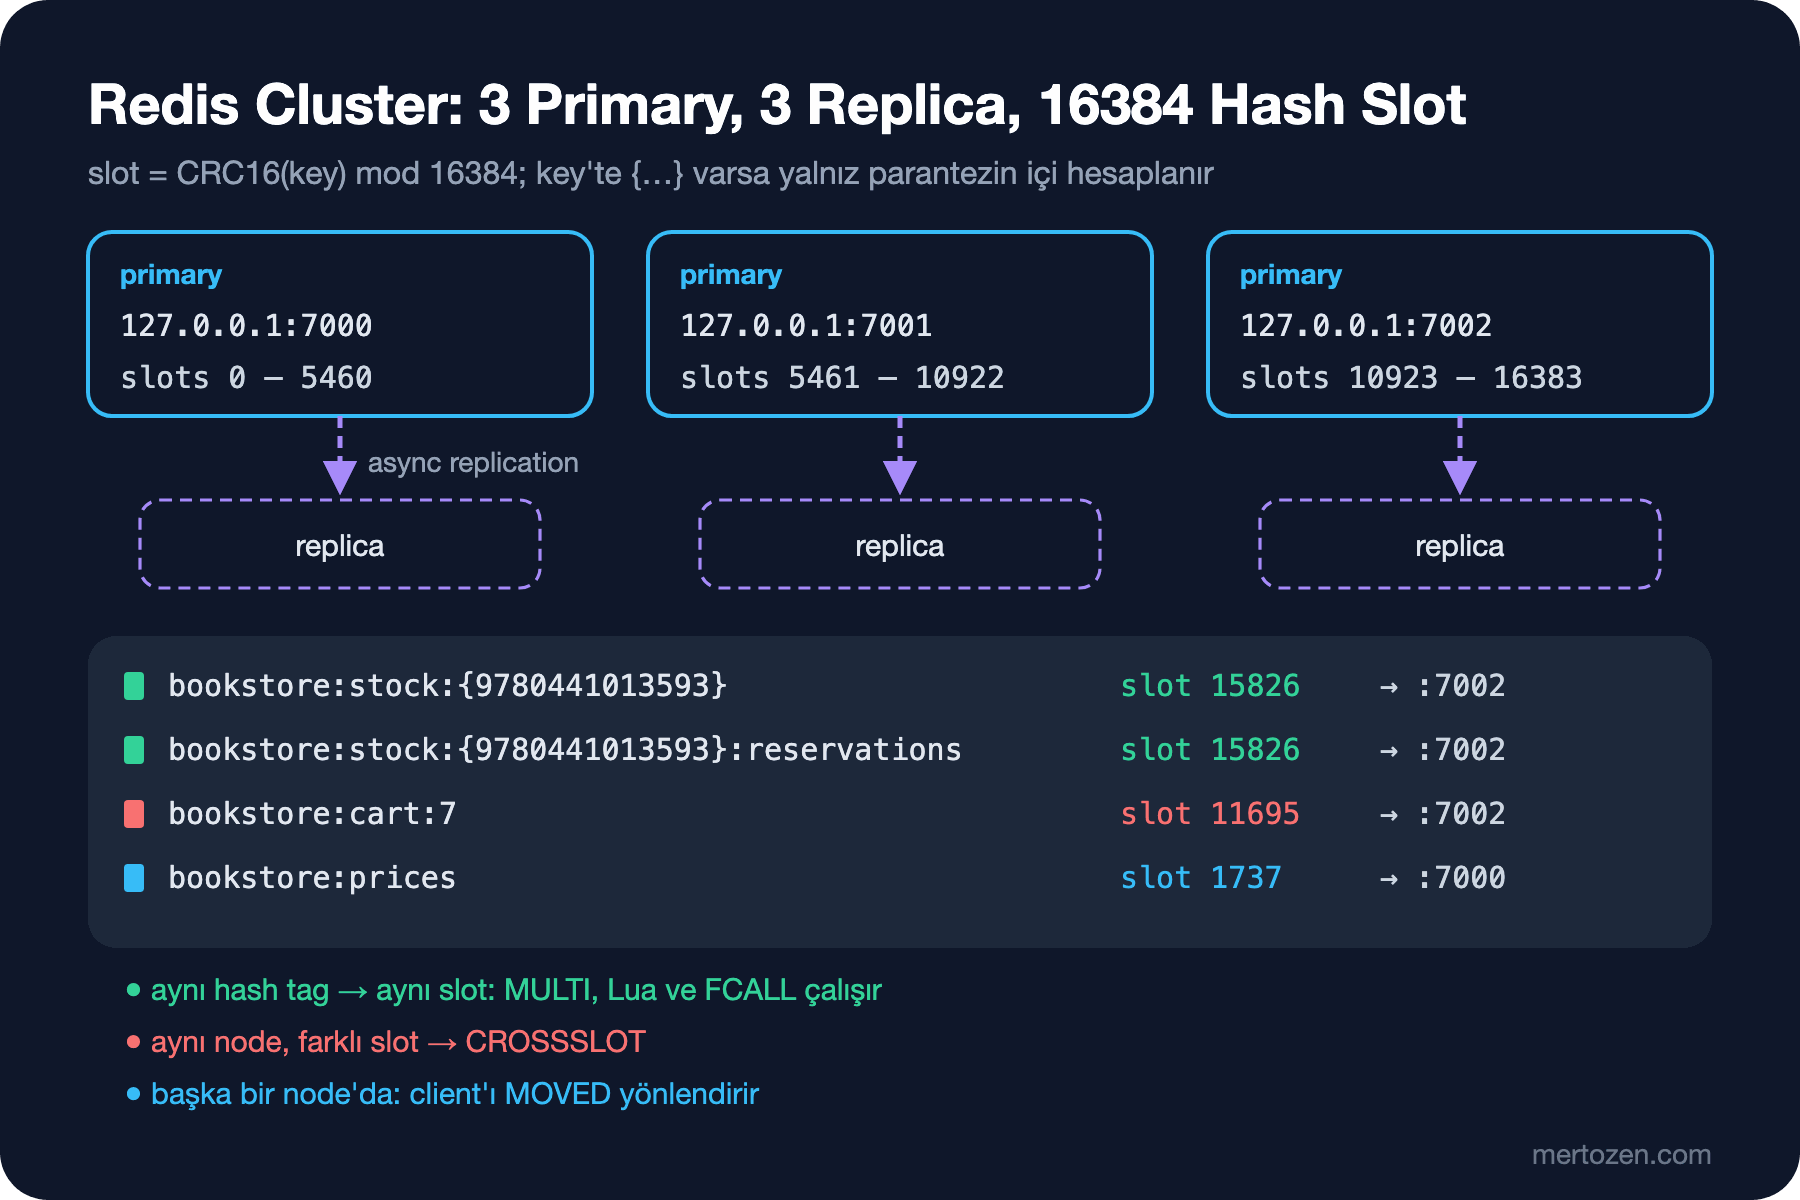
lab/cluster'daki container altı Redis process'i başlatıp redis-cli --cluster create … --cluster-replicas 1 ile cluster'ı kuruyor; slot'lar 0–5460, 5461–10922 ve 10923–16383 olarak dağıldı. Lab'daki start.sh Linux container'ının içinde çalıştığı için Windows'ta klonlarken satır sonları CRLF'e (Windows'un satır sonu karakterleri) dönerse script bozulur; repodaki .gitattributes *.sh dosyalarını LF (Linux'un satır sonu karakteri) olarak tutuyor.
MOVED, CROSSSLOT ve Hash Tag
127.0.0.1:7000> CLUSTER KEYSLOT bookstore:stock:{9780441013593}
(integer) 15826
127.0.0.1:7000> CLUSTER KEYSLOT bookstore:stock:{9780441013593}:reservations
(integer) 15826
127.0.0.1:7000> CLUSTER KEYSLOT bookstore:cart:7
(integer) 11695
127.0.0.1:7000> SET bookstore:cart:7 x
(error) MOVED 11695 127.0.0.1:7002
127.0.0.1:7002> MSET bookstore:stock:{9780441013593} 5 bookstore:stock:{9780441013593}:note restock
OK
127.0.0.1:7002> MSET bookstore:stock:{9780441013593} 5 bookstore:cart:7 x
(error) CROSSSLOT Keys in request don't hash to the same slot
127.0.0.1:7002> SELECT 1
(error) ERR SELECT is not allowed in cluster mode
Node, sahibi olmadığı bir slot için komutu çalıştırmıyor, MOVED ile doğru node'u söylüyor; cluster'ı destekleyen bir client (ya da redis-cli -c) bunu takip eder. Asıl kısıt çok key'li işlemlerde: MSET, MULTI/EXEC, Lua ve Functions'ın bütün key'leri aynı slot'ta olmalı. Stok key'i ile sepet key'i aynı node'da olduğu hâlde farklı slot'larda oldukları için CROSSSLOT aldık. 08'deki stok key'lerinin süslü parantezleri bu yüzden vardı: bir kitabın stok ve rezervasyon key'leri {isbn} sayesinde hep aynı slot'ta ve rezervasyon script'i cluster'da değişmeden çalışıyor. Cluster'da yalnız database 0 var.
StackExchange.Redis aynı kontrolü komutu göndermeden yapıyor:
dotnet run --project src/Bookstore.RedisLab -- cluster-keysbookstore:stock:{9780441013593} slot 15826 on 127.0.0.1:7002
bookstore:stock:{9780441013593}:reservations slot 15826 on 127.0.0.1:7002
bookstore:cart:7 slot 11695 on 127.0.0.1:7002
script on {9780441013593} keys: stock left 1
MSET stock + cart: RedisCommandException: Multi-key operations must involve a single slot; keys can use 'hash tags' to help this, i.e. '{/users/12345}/account' and '{/users/12345}/contacts' will always be in the same slot
EVAL stock + cart: RedisCommandException: Multi-key operations must involve a single slot; keys can use 'hash tags' to help this, i.e. '{/users/12345}/account' and '{/users/12345}/contacts' will always be in the same slotİlk denemede multiplexer'a localhost:7000 verdim; cluster kendini 127.0.0.1 ile duyurduğu için GetServers() her node'u iki kez listeledi ve localhost kayıtlarına giden bir CONFIG SET timeout'a düştü. Seed adresleri cluster'ın duyurduğu adreslerle aynı olmalı. Hash tag'i her şeye koymak da çözüm değil: bütün key'ler aynı tag'i taşırsa hepsi tek slot'a, yani tek node'a düşer ve cluster'ın anlamı kalmaz. Tag'i birlikte işlem gören en küçük gruba (bir kitap, bir müşterinin sepeti) ver.
08'deki Functions kütüphanesinde de bir sürpriz var: FUNCTION LOAD yalnız gönderildiği node'a yüklüyor.
$ redis-cli -c -p 7000 -x FUNCTION LOAD REPLACE < /lab/functions/bookstore.lua
bookstore
$ redis-cli -c -p 7000 FCALL reserve_stock 2 ...
ERR Function not found
$ sh -c 'for p in 7000 7001 7002; do redis-cli -p $p -x FUNCTION LOAD REPLACE < /lab/functions/bookstore.lua; done'
bookstore
bookstore
bookstore
$ redis-cli -c -p 7000 FCALL reserve_stock 2 ...
1
Kütüphane 7000'e yüklendi, ama stok key'inin slot'u 7002'de olduğu için FCALL orada çalıştı ve function'ı bulamadı. Deploy adımı kütüphaneyi her primary'ye yüklemeli (replica'lar primary'lerinden alıyor) ve cluster'a sonradan eklenen node'ları unutmamalı.
Cluster'da Pub/Sub ve Keyspace Notification'ları
09'daki klasik PUBLISH cluster'da bütün node'lara yayılıyor; sharded pub/sub (SPUBLISH/SSUBSCRIBE) ise kanalı da bir slot'a bağlayıp mesajı yalnız o slot'un node'unda tutuyor. Keyspace notification'lar ise hiç yayılmıyor: her node yalnız kendi key'leri için olay üretiyor. Üç primary'de notify-keyspace-events Ex açıp tek bir subscriber ile __keyevent@0__:expired'a abone oldum ve 300 key'i 500 ms TTL ile yazdım:
dotnet run --project src/Bookstore.RedisLab -- cluster-notifications300 keys expired (98 + 105 + 97 per primary), notifications received: 98Subscriber yalnız bağlı olduğu node'un 98 olayını aldı. Cluster'da expire olaylarına dayanan bir iş, her primary'ye ayrı abone olmak zorunda; topology değiştikçe bu listeyi güncel tutmak da ayrı iş. Çoğu durumda 10'daki stream'e açık bir olay yazmak daha sağlam.
Failover ve Slot Taşıma
Cluster'da failover'ı Sentinel değil node'ların kendisi yapıyor. 50 farklı sepet key'ine her 100 ms'de yazan bir döngü çalışırken 7002'yi kapattım:
   4.9s first failure: RedisConnectionException: SocketClosed on 127.0.0.1:7002/Interactive
  17.1s writes succeed again (primary for slot of bookstore:cart:0: 127.0.0.1:7001)
  30.1s done: 8658 writes ok, 42 failed
Node log'larına göre cluster-node-timeout 5000 ile node 8,2 saniye sonra FAIL işaretlendi, replica'sı 0,6 saniye sonra seçimi kazandı. Arada bütün primary'ler 0,7 saniye cluster_state:fail'e geçti: cluster-require-full-coverage yes varsayılanıyla bir slot aralığı sahipsiz kalınca cluster sağlam node'lardaki slot'lar için de yazmaları reddediyor. Client tarafında ilk hatadan bütün turun yeniden başarılı olmasına kadar 12,2 saniye geçti; topology'nin client'ta güncellenmesi de bu süreye ekleniyor. StackExchange.Redis 3.4.0'ın sürüm notları cluster failover'dan daha hızlı toparlanmayı bir iyileştirme olarak listeliyor; kullandığın paketin güncel olması bu sürede fark eder.
Slot'ları bir node'dan diğerine taşımak eskiden key key MIGRATE ile yapılıyordu ve taşıma sırasında client'lar ASK yönlendirmesi alıyordu. Redis 8.4'ün atomic slot migration'ı slot'u bir bütün olarak taşıyor; komut hedef node'da çalıştırılıyor:
$ redis-cli -p 7000 CLUSTER MIGRATION IMPORT 15826 15826
93fd0a67a41ecd0c5a7a12ba9c16d620fffe8c34
$ redis-cli -p 7002 GET bookstore:stock:{9780441013593}
MOVED 15826 127.0.0.1:7000
$ redis-cli -p 7000 HLEN bookstore:stock:{9780441013593}:reservations
20000
CLUSTER MIGRATION STATUS ALL işin completed olduğunu, 7 ms sürdüğünü ve write_pause_ms'in 0 olduğunu gösterdi; 20.000 field'lı rezervasyon hash'i slot'la birlikte geldi. Redis 8.10'da redis-cli --cluster reshard da bu mekanizmayı kullanıyor. Valkey 9'un atomic slot migration'ı aynı işi farklı bir komutla, kaynak node'da yapıyor: CLUSTER MIGRATESLOTS SLOTSRANGE 15826 15826 NODE <id>; Valkey 9.1.3'te denediğimde slot taşındı, CLUSTER MIGRATION ise bilinmeyen subcommand oldu.
Valkey Farkları ve Ne Zaman Cluster?
Aynı lab'ı CLUSTER_IMAGE=valkey/valkey:9 ile Valkey'de çalıştırdım. Valkey 9 cluster'da birden çok database'i destekliyor, ama varsayılan olarak değil: cluster-databases varsayılanı 1, değiştirilemez bir ayar ve SELECT 1 DB index is out of range verdi. Ayrı bir container'da --cluster-databases 16 ile başlatınca database 1'e yazılan key database 0'da görünmedi. Redis 8.10.3'te ise cluster'da SELECT her durumda reddediliyor; database'lerle ayrılmış bir uygulamayı Redis Cluster'a taşırken key prefix'lerine geçmek gerekiyor.
Ne zaman tek primary + replica + Sentinel yeter? Veri tek makinenin belleğine rahatça sığıyorsa ve yazma yükü tek bir event loop'un kaldırabileceği kadarsa (lab'daki tek bir Redis, redis-benchmark ile 20 bağlantıdan gönderilen HGET'lere saniyede 238.000'in üzerinde cevap verdi). Cluster'ı veri ya da yazma yükü tek node'u aştığında seç; bedeli çok key'li işlemlerde hash tag disiplini, node başına Functions yüklemesi ve node-local notification'lar. Managed serviste bu karar bir ayar: Azure Managed Redis her zaman içeride shard'lı çalışıyor ve üç cluster policy sunuyor. OSS (açık kaynak Redis'in cluster API'si) policy client'ın cluster protokolünü konuşmasını istiyor ve çok key'li komutların aynı slot'ta olması gerekiyor; Enterprise policy tek bir endpoint arkasında proxy kullanıyor ve slot'lar arasında yalnız DEL, MSET, MGET, EXISTS, UNLINK ve TOUCH'a izin veriyor; Non-clustered policy 25 GB ve altı için. Microsoft'un dokümanına göre RediSearch modülü OSS policy ile kullanılamıyor; 11'deki katalog araması için Enterprise ya da Non-clustered gerekiyor. Kubernetes'te Redis'i StatefulSet olarak çalıştırma kararı Kubernetes serisinin "Kubernetes'te Storage ve Stateful Uygulamalar: Volume, PersistentVolumeClaim, StatefulSet ve Veritabanı Kararı" yazısında.
Üretimde Dikkat
Sentinel'leri en az üç ayrı makineye koy ve quorum'u çoğunluk olarak ayarla. INFO replication'da master_link_status, replica'nın slave_repl_offset'i ile primary'nin master_repl_offset'i arasındaki fark (replication lag) ve connected_slaves izlenecek değerler. Replica'nın output buffer sınırını varsayılan (256 MB/64 MB/60 sn) bırak; Önce Tahmin Et'teki 1 MB yalnız kopmayı canlandırmak içindi. Persistence'ı kapalı bir primary'nin otomatik restart'ı tehlikeli: boş açılırsa replica'lar ona bağlanıp kendi verilerini de silebilir; dokümanın replication sayfası bu senaryoyu ayrıca anlatıyor. Cluster'da hash tag tasarımını uygulama ilk yazılırken yap; sonradan key adı değiştirmek veri taşıması demek. Client'ta failover süresini ölç: bu yazıda Sentinel'de 5,4, cluster'da 12,2 saniye.
Sık Düşülen Tuzaklar
WAIT 1 döndü diye yazmanın kalıcı olduğunu sanmak, 0 döndüğünde ise yazmanın geri alındığını sanmak.
Replication'ı backup yerine koymak: FLUSHALL ya da yanlış bir DEL replica'ya da gider.
Üç Sentinel'i aynı makineye koymak: makine giderse failover yapacak kimse kalmaz.
Cluster'da çok key'li işlemleri hash tag'siz tasarlamak: aynı node'daki key'ler bile CROSSSLOT aldı.
Bütün key'lere aynı hash tag'i vermek: veri tek slot'a yığılır.
Functions kütüphanesini tek node'a yüklemek: diğer slot'larda Function not found.
Keyspace notification'ları cluster'da tek bağlantıdan dinlemek: 300 olaydan 98'i geldi.
Multiplexer'a cluster'ın duyurduğundan farklı seed adresi vermek.
Küçük Bir Deneme
★☆☆ Sentinel lab'ında primary'de CONFIG SET min-replicas-to-write 1 ve min-replicas-max-lag 5 ayarla, replica'yı kill -STOP ile durdur ve birkaç saniye sonra INCR gönder. Hangi hatayı alıyorsun?
★★☆ sentinel-failover'ı connection string'e syncTimeout=1000,asyncTimeout=1000 ekleyerek tekrar çalıştır. Hata sayısı ve yazmaların durduğu süre nasıl değişiyor?
★★★ Bookstore.Api'yi cluster'a bağla (ConnectionStrings:Redis = 127.0.0.1:7000,127.0.0.1:7001,127.0.0.1:7002) ve bütün endpoint'leri dene. Hangisi CROSSSLOT hatası veriyor (ipucu: 06 ve 08'deki haftalık çok satanlar snapshot'ı)? Key adlarını nasıl değiştirirdin?
Bir sonraki yazıda Redis'i production'da işletmeye geçiyoruz: ACL (Access Control List; kullanıcı bazında komut ve key izinleri) kullanıcıları, TLS (bağlantıyı şifreleyen protokol), tehlikeli komutlar, 2025–2026'daki Lua açıkları ve patch disiplini, SLOWLOG ve LATENCY DOCTOR ile teşhis, StackExchange.Redis'in timeout mesajını okumak, OpenTelemetry ve Testcontainers ile integration testi.