

Pipeline'ı Ölçmek ve Hızlandırmak: DORA Metrikleri, Cache ve Paralellik
DORA'nın güncel beş metriği (change lead time, deployment frequency, failed deployment recovery time, change fail rate, deployment rework rate) deploy kayıtlarından hesaplanır ve ekip bazında trend olarak izlenmelidir; pipeline'ı hızlandırmak ise ölçümle başlar. Tek dosyalık bir C# hesaplayıcı, act'te NuGet cache'inin restore'u sadece 0,2 saniye hızlandırıp 2,3 saniyelik geri yükleme maliyeti getirdiği gerçek ölçüm, cache key tasarımı ve path filter tuzağı.
Sürüm notu: Bu yazıdaki örnekler .NET 10 (SDK 10.0.402), Node.js 24, act 0.2.97, actionlint 1.7.12 ve Docker 29 ile denenmiştir.
Önce Tahmin Et
Bookstore'un pipeline'ına NuGet paketleri için bir cache ekliyorsun; key lock dosyalarının hash'inden üretiliyor. İlk koşuda cache boş, ikinci koşuda dolu. dotnet restore ikinci koşuda ne kadar hızlanır: yarıya mı iner, onda bire mi, yoksa neredeyse hiç değişmez mi? Cache'i geri yüklemenin kendisi kaç saniye sürer? Tahminini yaz; act ile ölçtüğüm gerçek sayılar ortadaki bölümde.
DORA'nın Beş Metriği
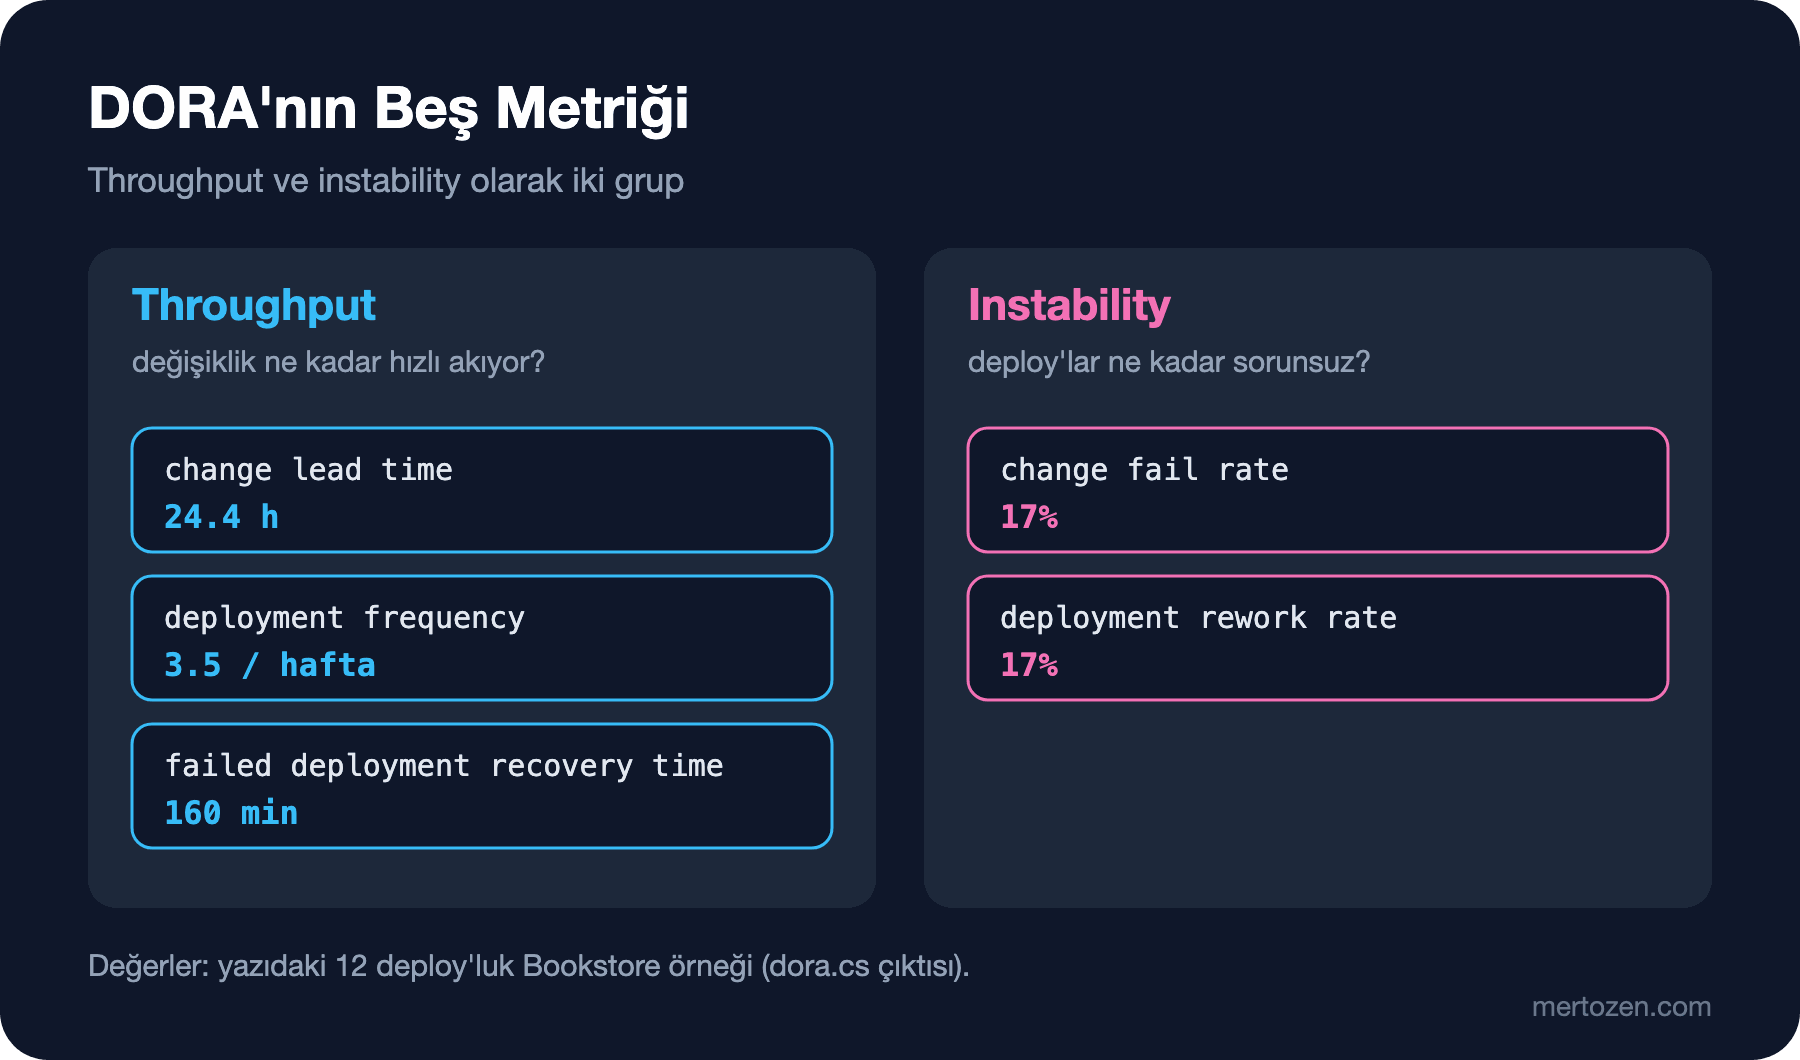
DORA (DevOps Research and Assessment), yazılım teslimat performansını beş metrikle ölçüyor. dora.dev'in Ocak 2026'da güncellenen rehberine göre bunlar iki gruba ayrılıyor. Throughput, değişikliklerin sistemden ne kadar hızlı aktığını ölçüyor: change lead time (commit'in version control'e girmesinden production'a deploy edilmesine kadar geçen süre), deployment frequency (belirli bir dönemde kaç deploy yapıldığı) ve failed deployment recovery time (acil müdahale gerektiren başarısız bir deploy'dan toparlanma süresi). Instability ise deploy'ların ne kadar sorunsuz gittiğini ölçüyor: change fail rate (revert ya da acil yama gibi acil takip gerektiren deploy'ların oranı) ve deployment rework rate (planlanmamış, bir production olayı yüzünden yapılan deploy'ların oranı).
Bu model zaman içinde değişti. 2014 araştırması dört değişkenle başladı ve 2015 raporu dört metrikli throughput ve stability modelini oturttu. Eski MTTR (Mean Time To Recovery) metriği 2023 raporunda failed deployment recovery time adını aldı; tanım artık genel olarak "herhangi bir arıza" değil, deploy'dan kaynaklanan arızayla ilgili. Deployment rework rate 2024 raporuyla eklendi ve model beş metriğe çıktı. Eski bir sunumda "dört anahtar metrik" ya da MTTR görürsen bu geçmişten.
Metrikleri Deploy Kayıtlarından Hesaplamak
Metriklerin ham maddesi deploy kayıtları. Bookstore'un son dört haftasından 12 production deploy'unu bir CSV (Comma-Separated Values) dosyasına döktüm. Her satırda deploy'a giren ilk commit'in zamanı, deploy zamanı, deploy'un planlı mı yoksa bir olay yüzünden mi yapıldığı, başarısız olup olmadığı ve başarısızsa hizmetin ne zaman normale döndüğü var:
id,first_commit_at,deployed_at,trigger,failed,restored_at
101,2026-10-05T09:10,2026-10-06T11:00,planned,no,
102,2026-10-06T14:00,2026-10-07T10:30,planned,no,
103,2026-10-08T10:00,2026-10-09T16:00,planned,yes,2026-10-09T17:20
104,2026-10-09T16:40,2026-10-09T17:20,incident,no,
105,2026-10-12T09:00,2026-10-13T11:00,planned,no,
106,2026-10-13T13:30,2026-10-14T15:00,planned,no,
107,2026-10-15T10:00,2026-10-16T10:00,planned,no,
108,2026-10-19T11:00,2026-10-20T09:45,planned,yes,2026-10-20T13:45
109,2026-10-20T12:10,2026-10-20T13:45,incident,no,
110,2026-10-21T10:00,2026-10-22T14:00,planned,no,
111,2026-10-26T09:30,2026-10-27T10:15,planned,no,
112,2026-10-28T15:00,2026-10-29T11:30,planned,no,
103 ve 108 başarısız deploy'lar; 104 ve 109 onları düzelten, olay yüzünden yapılmış hotfix deploy'ları. Hesabı .NET 10'un file-based app özelliğiyle tek bir C# dosyasında yaptım; proje dosyası gerekmiyor, dotnet run dora.cs yeterli:
// kullanım: dotnet run dora.cs -- deployments.csv
using System.Globalization;

string[] lines = File.ReadAllLines(args[0]);
List<Deployment> deployments = lines.Skip(1).Select(Deployment.Parse).ToList();

double days = (deployments.Max(d => d.DeployedAt) - deployments.Min(d => d.DeployedAt)).TotalDays + 1;
TimeSpan medianLeadTime = Median(deployments.Select(d => d.DeployedAt - d.FirstCommitAt));
List<Deployment> failed = deployments.Where(d => d.Failed).ToList();
TimeSpan medianRecovery = Median(failed.Select(d => d.RestoredAt!.Value - d.DeployedAt));
int incidentDriven = deployments.Count(d => d.Trigger == "incident");

Console.WriteLine($"deployments           : {deployments.Count} in {days:0} days");
Console.WriteLine($"deployment frequency  : {deployments.Count / days * 7:0.0} per week");
Console.WriteLine($"change lead time      : {medianLeadTime.TotalHours:0.0} h (median)");
Console.WriteLine($"change fail rate      : {(double)failed.Count / deployments.Count:P0}");
Console.WriteLine($"recovery time         : {medianRecovery.TotalMinutes:0} min (median)");
Console.WriteLine($"deployment rework rate: {(double)incidentDriven / deployments.Count:P0}");

static TimeSpan Median(IEnumerable<TimeSpan> values)
{
    TimeSpan[] sorted = values.Order().ToArray();
    int mid = sorted.Length / 2;
    return sorted.Length % 2 == 1 ? sorted[mid] : (sorted[mid - 1] + sorted[mid]) / 2;
}

record Deployment(int Id, DateTime FirstCommitAt, DateTime DeployedAt, string Trigger, bool Failed, DateTime? RestoredAt)
{
    public static Deployment Parse(string line)
    {
        string[] f = line.Split(',');
        return new(int.Parse(f[0]), Time(f[1]), Time(f[2]), f[3], f[4] == "yes",
            f[5].Length > 0 ? Time(f[5]) : null);
    }

    private static DateTime Time(string value) =>
        DateTime.ParseExact(value, "yyyy-MM-ddTHH:mm", CultureInfo.InvariantCulture);
}
$ dotnet run dora.cs -- deployments.csv
deployments : 12 in 24 days
deployment frequency : 3.5 per week
change lead time : 24.4 h (median)
change fail rate : 17%
recovery time : 160 min (median)
deployment rework rate: 17%Birkaç tasarım kararı var. Süreler için ortalama değil medyan kullandım: tek bir unutulmuş PR'ın (pull request) üç haftalık lead time'ı ortalamayı uçurur, medyanı neredeyse hiç etkilemez. Lead time'ın başlangıcı olarak deploy'a giren ilk commit'i aldım; son commit'i almak süreyi olduğundan kısa gösterir. Bu örnekte change fail rate ile rework rate aynı çıktı, çünkü her başarısız deploy bir hotfix ile düzeltildi. Gerçekte ikisi ayrışabilir: revert ile geri alınan bir deploy fail rate'e girer ama yeni bir deploy gerektirmeyebilir; tersine, bir production olayı deploy'la ilgisi olmayan bir sebepten çıkıp yine de acil bir deploy gerektirebilir.
Bu verinin kaynağı pipeline'ın kendisi olmalı: GitHub'ın deployment kayıtları, Jenkins build geçmişi, Azure DevOps environment geçmişi. "Bu deploy bir olay yüzünden mi yapıldı?" sorusunu otomatik cevaplamak için bir işaret gerekiyor; bir PR etiketi (hotfix) ya da olay yönetim aracındaki kaydın deploy'a bağlanması gibi. Elle tutulan bir tablo ilk hafta doğrudur, üçüncü ay eksiktir.
Hızlandırmadan Önce Ölç
Pipeline yavaş olduğunda ilk refleks cache eklemek. Önce lokalde ne kadar kazanç olabileceğine baktım: NuGet ve npm için boş bir paket klasörüyle (cold) ve dolu klasörle (warm) restore süreleri:
cold nuget restore: 3.1 s
warm nuget restore: 0.6 s
cold npm ci: 6.3 s
warm npm ci: 3.0 s
Lokalde tablo net: NuGet beş kat, npm iki kat hızlanıyor. Sonra aynı şeyi act'te, gerçek bir cache adımıyla ölçtüm. Workflow:
name: cache

on:
  push:
    branches: [main]

jobs:
  api:
    runs-on: ubuntu-latest
    env:
      NUGET_PACKAGES: ${{ github.workspace }}/.nuget/packages
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-dotnet@v6
        with:
          global-json-file: global.json
      - uses: actions/cache@v6
        with:
          path: ${{ env.NUGET_PACKAGES }}
          key: nuget-${{ runner.os }}-${{ hashFiles('**/packages.lock.json') }}
          restore-keys: |
            nuget-${{ runner.os }}-
      - run: dotnet restore --locked-mode
İlk koşu (cache boş) ve ikinci koşu (cache dolu):
== run 1
[cache/api]   | Cache not found for input keys: nuget-Linux-44e642d144dc04b17fdc02508da3f79f055a90d012f32b89b5038b3ebeb611dd, nuget-Linux-
[cache/api]   ✅  Success - Main actions/cache@v6 [1.006575458s]
[cache/api]   ✅  Success - Main dotnet restore --locked-mode [4.740434375s]
[cache/api]   | Cache saved with key: nuget-Linux-44e642d144dc04b17fdc02508da3f79f055a90d012f32b89b5038b3ebeb611dd
[cache/api]   ✅  Success - Post actions/cache@v6 [3.165430209s]
== run 2
[cache/api]   | Cache Size: ~97 MB (102144202 B)
[cache/api]   | Cache restored successfully
[cache/api]   ✅  Success - Main actions/cache@v6 [2.288465333s]
[cache/api]   ✅  Success - Main dotnet restore --locked-mode [4.551417333s]
[cache/api]   ✅  Success - Post actions/cache@v6 [198.937125ms]
Giriş sorusunun cevabı: restore 4,74 saniyeden 4,55 saniyeye indi, yani 0,2 saniye kazandık. Karşılığında 97 MB'lık cache'i geri yüklemek 2,3 saniye, ilk koşuda kaydetmek 3,2 saniye sürdü. Bu ortamda cache net bir kayıp. Sebebi: paketleri nuget.org'dan indirmek hızlı bir ağda zaten ucuzdu, restore süresinin geri kalanı ise indirme değil MSBuild'in projeleri değerlendirmesi. Cache'in 97 MB olması da dikkat çekici: Testcontainers ve test bağımlılıkları dahil bütün paket ağacı orada.
Bu, cache'in faydasız olduğu anlamına gelmiyor. Yavaş ya da kotalı bir ağda, büyük bir bağımlılık ağacında ya da paket kaynağının ara sıra yavaşladığı bir kurulumda tablo tersine dönebilir. Ders şu: cache'i varsayımla değil ölçümle ekle ve ölçümü kendi runner'ında yap; benim sayılarım act ile yerelde alındı, GitHub'ın runner'larında koşulmadı.
Cache Key Tasarımı
Key'in iki işi var: içerik değiştiğinde değişmek ve değişmediğinde aynı kalmak. Yukarıdaki key üç parçadan oluşuyor. nuget öneki cache'in ne olduğunu söylüyor. runner.os, Linux'ta üretilen bir cache'in Windows runner'ına yüklenmesini engelliyor. hashFiles('**/packages.lock.json') ise bağımlılık değiştiği anda yeni bir key üretiyor. Lock dosyası burada csproj'dan daha iyi bir girdi: csproj'daki bir yorum değişikliği cache'i boşa düşürmez, transitive bir paketin sürüm değişikliği ise düşürür.
restore-keys bir yedek plan: tam eşleşme yoksa aynı önekle başlayan en yeni cache yükleniyor, restore sadece eksik paketleri indiriyor. Bağımlılıkların çoğu aynı kaldığında bu, tamamen boş bir cache'ten iyidir.
Hazır kısayollar da var: actions/setup-node'un cache: npm seçeneği ve actions/setup-dotnet'in cache: true seçeneği aynı mantıkla, lock dosyalarından key üretiyor. npm tarafında cache'lenecek şey node_modules değil npm'in kendi cache klasörü: npm ci başlamadan önce mevcut node_modules'ü siliyor.
Affected-Only Build ve Path Filter
Bookstore'un API'si (Application Programming Interface) ve web uygulaması aynı repository'de. Sadece Angular tarafında bir CSS (Cascading Style Sheets) değişikliği yapıldığında API'nin build ve testlerini koşturmak boşa harcanan dakikalar. GitHub Actions'ta en basit çözüm path filter:
name: web

on:
  push:
    branches: [main]
    paths:
      - 'web/**'
      - '.github/workflows/web.yml'
  pull_request:
    paths:
      - 'web/**'

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - run: echo "web changed, building bookstore-web"
Workflow dosyasının kendisini de listeye eklemek önemli; aksi halde workflow'u değiştiren commit onu tetiklemez ve değişiklik test edilmeden kalır. Bu dosyayı ekleyen commit act'te workflow'u koşturdu. Sadece API'ye dokunan bir commit'le act'in path filter'ı nasıl değerlendirdiğini doğrulayamadım; act koşusu sonuç vermeden takıldı. Bu davranışı actionlint ve GitHub dokümantasyonuyla doğruladım, GitHub'da koşmadım.
Path filter'ın bilinen bir tuzağı var: GitHub dokümantasyonuna göre path filter yüzünden atlanan bir workflow'un check'leri "Pending" durumunda kalıyor ve bu check required ise PR merge edilemiyor. Required check'leri path filter'lı workflow'lara bağlama; ya filtreyi job seviyesinde bir koşulla yap (koşul yüzünden atlanan job "Success" raporluyor) ya da değişen yolları bulan küçük bir ilk job yazıp diğer job'ları onun output'una göre çalıştır. Çok projeli bir monorepo'da ise "affected" analizi yapan build tool'ları (Nx, Bazel gibi) bu işi bağımlılık graph'ı üzerinden yapıyor.
Paralellik, Artifact Boyutu ve Runner Maliyeti
İkinci yazıda api ve web paralel koştuğunda pipeline'a yaklaşık 10 saniye eklediğini, sıralı koşsalar 18 saniye ekleyeceklerini görmüştük. Paralelliğin bir bedeli de var: her job kendi makinesinde başlıyor, yani her job checkout'u ve SDK kurulumunu yeniden yapıyor. Bookstore'da setup-dotnet adımı tek başına 15 saniye sürdü. Bir job'ı ikiye bölmek, bu 15 saniyeyi ikinci kez ödemek demek. İşi bölmenin kazancı, bölünen işin süresi bu sabit maliyetten belirgin şekilde büyükse var.
Artifact boyutu da süreye yansıyor: her upload ve download ağdan geçiyor. Bookstore'un API artifact'ında .pdb dosyaları da var; production'a gidecek pakette onlara ihtiyaç olup olmadığı, hata ayıklama stratejine bağlı bir karar. Saklama süresini kısaltmak (retention-days) depolama maliyetini düşürüyor.
Son olarak runner maliyeti. Private repository'lerde GitHub-hosted runner'lar dakika üzerinden ücretlendiriliyor; daha büyük runner'lar dakika başına daha pahalı ama işi daha kısa sürede bitirebiliyor. Hangi kombinasyonun ucuz olduğu yine ölçümle bulunur: toplam süre çarpı dakika ücreti, ve geliştiricinin beklediği süre.
Üretimde Dikkat: Metrikleri Oyunlaştırmak
Goodhart yasası olarak bilinen gözlem, ekonomist Charles Goodhart'ın 1975 tarihli bir tespitinden geliyor ve genellikle şöyle ifade ediliyor: bir ölçü hedef haline geldiğinde iyi bir ölçü olmaktan çıkar. DORA metriklerinde bunun nasıl olacağını tahmin etmek zor değil. Deployment frequency hedef olursa ekipler değişiklikleri anlamsız parçalara böler. Change fail rate hedef olursa başarısız deploy'lar "başarısız" diye işaretlenmez. Lead time hedef olursa ilk commit yerine son commit'ten ölçülmeye başlanır.
Benim önerim üç kural. Metrikleri ekip seviyesinde tut, kişi seviyesinde değil; teslimat bir ekip sporu. Mutlak değerlere değil trendlere bak: Bookstore'un lead time'ının bu çeyrekte geçen çeyreğe göre nereye gittiği, başka bir ekibin sayısından daha anlamlı. Ve beş metriğe birlikte bak: throughput artarken instability de artıyorsa hız güvenlikten çalınıyor demektir.
Sık Düşülen Tuzaklar
Ölçmeden optimize etmek: yukarıdaki cache örneğinde olduğu gibi, sezgiyle eklenen bir optimizasyon pipeline'ı yavaşlatabilir.
Yanlış key: çok geniş bir key (yalnızca nuget-Linux) eski paketleri sonsuza kadar taşır; çok dar bir key, örneğin commit'in SHA (Secure Hash Algorithm) değeri, her koşuda ıskalar ve sadece kaydetme maliyeti bırakır.
node_modules'ü cache'lemek: npm ci onu zaten siliyor; cache'lenmesi gereken npm'in cache klasörü.
Required check'i path filter'lı bir workflow'a bağlamak: ilgisiz bir değişiklikte PR "Pending" check'te takılır.
Metrikleri elle toplamak: veri eksik ve geç gelir, ve kimse güvenmez. Kaynak pipeline'ın kendi kayıtları olmalı.
Küçük Bir Deneme
★☆☆ Son bir ayın production deploy'larını bir CSV'ye dök ve dora.cs'i kendi verinle koştur. Hangi metriği hesaplamak için elinde veri yoktu?
★★☆ Pipeline'ına bir cache adımı ekle ve en az üçer koşu ile cache'li ve cache'siz süreleri karşılaştır. Cache'in geri yükleme süresi, kazandırdığı süreden az mı?
★★★ Repository'nde required olan bir check'i path filter'lı bir workflow'a bağla, sonra ilgisiz bir dosyayı değiştiren bir PR aç. PR'ın durumu ne oldu? Sorunu job seviyesinde bir koşulla çöz.
Bu yazıyla CI (Continuous Integration) ve CD (Continuous Delivery) üzerine kurduğumuz CI/CD Temelleri serisi bitiyor. Pipeline'ı neden böyle kurduğumuzun cevabını tool'dan bağımsız olarak toparladık: sık entegrasyon, bir kez build edilen artifact, ucuzdan pahalıya dizilmiş testler, configuration ile ayrışan environment'lar, doğru yere konmuş onaylar, kısa ömürlü credential'lar ve ölçerek hızlanmak. Aynı fikirleri tool'un diliyle uygulamak ilerideki GitHub Actions, Jenkins ve Azure DevOps Pipelines serilerinin konusu; deploy ile release'i ayırmak ise Deployment Stratejileri serisinin.