

Agent'ları Değerlendirmek: Trajectory, Tool Call Accuracy, Task Adherence ve Production Gözlemi

Bir agent'ı değerlendirmek için sonucu, izlediği yolu (trajectory) ve maliyeti ayrı ayrı ölçer, aynı senaryoyu fake tool'larla N kez koşturup başarı oranı raporlarsın; LLM-as-judge ancak kod kontrollerinden sonra ve gerekçesi okunarak kullanılır. Kendi trajectory kaydımızı, deterministik senaryoları, Microsoft.Extensions.AI.Evaluation'ın agent evaluator'larının yerel modellerle gerçek sonuçlarını ve OpenTelemetry span'lerinden regresyon setine giden yolu görüyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Microsoft.Extensions.AI 10.11.0, Microsoft.Extensions.AI.Evaluation ve .Quality 10.11.0 ile OllamaSharp 5.5.2 kullanılarak derlenip denenmiştir; agent modeli yerel Ollama'daki qwen3:4b; judge olarak qwen3:4b, gemma3:12b ve gemma3:4b denendi.
Önce Tahmin Et
Bookstore agent'ına "Put two copies of Winter in Kyoto in my cart." diyorsun. Aynı model, aynı system prompt, aynı tool'lar, aynı veri. Agent'ı üç kez çalıştırıyorsun ve üçünde de iki kitap sepete giriyor. Üç koşu aynı yoldan mı gitti? Aynı sayıda adım, aynı token, aynı süre mi?
Hayır. İlk koşu search_books, check_stock, add_to_cart ile 7 adımda, 110 saniyede, 5874 token'la bitti. İkincisi stoğa hiç bakmadan search_books ve add_to_cart ile 5 adımda, ama 220 saniyede ve 3827 token'la. Üçüncüsü yine 7 adım ama 8384 token. Sonuç üçünde de doğru; yol, maliyet ve süre farklı. Agent değerlendirmesinin ilk dersi bu: tek koşuya bakıp "geçti" demek, sonucu ölçer ama agent'ı ölçmez. Serinin son yazısında agent'ları nasıl ölçeceğimizi, kendi trajectory kaydımızla, deterministik fake tool'larla, N kez koşturmayla ve Microsoft.Extensions.AI.Evaluation'ın agent evaluator'larıyla göreceğiz.
Ne Ölçülür: Sonuç, Yol ve Maliyet
Bir agent'ın bir görevdeki performansını üç soruya bölüyorum:
| Soru | Ölçü | Bookstore örneği |
|---|---|---|
| Görevi başardı mı? (sonuç) | Cevapta beklenen bilgi var mı, sistemin son durumu doğru mu | Cevapta TRK-88213 geçiyor; sepette 2 adet kitap 4 var |
| Doğru yoldan mı? (trajectory) | Hangi tool, hangi argüman, hangi sırayla; yasak tool çağrıldı mı | get_order_status{"orderId":1043} çağrıldı, cancel_order çağrılmadı |
| Ne pahasına? (verimlilik) | Adım, tool çağrısı, token, süre | En fazla 3 tool çağrısı; token ve süre kaydedilir |
Yalnız sonucu ölçmek, yanlış yoldan doğru sonuca varan agent'ı ödüllendirir: stok sormadan "evet, var" diyen bir cevap bugün doğru olabilir, yarın değil. Yalnız yolu ölçmek ise farklı ama geçerli stratejileri cezalandırır: check_stock'u atlayan ikinci koşu kitabı yine doğru şekilde sepete ekledi. Bu yüzden yol kontrollerini "şu tool şu argümanla mutlaka çağrılmalı" ve "şu tool asla çağrılmamalı" gibi gevşek ama kritik kurallar olarak yazıyorum.
Trajectory'yi Kaydetmek
Ölçmek için önce kaydetmek gerekiyor. Agent loop'unu serinin 2. yazısındaki gibi FunctionInvokingChatClient yürütüyor; her model çağrısını görmek için onun içine bir DelegatingChatClient koyuyorum:
using System.Diagnostics;
using System.Text.Json;
using Microsoft.Extensions.AI;

namespace Bookstore.Agent.Eval;

public sealed record Step(int Index, string Kind, string Name, string Detail, long StartMs, long DurationMs, long? InputTokens, long? OutputTokens);

// Agent'ın bir koşusu: her model çağrısı ve her tool çağrısı, sırasıyla ve süreleriyle
public sealed class Trajectory
{
    private readonly Stopwatch _clock = Stopwatch.StartNew();
    public List<Step> Steps { get; } = [];

    public long Now => _clock.ElapsedMilliseconds;

    public void Add(string kind, string name, string detail, long startMs, long? inTokens = null, long? outTokens = null) =>
        Steps.Add(new Step(Steps.Count + 1, kind, name, detail, startMs, Now - startMs, inTokens, outTokens));

    public IEnumerable<Step> ToolCalls => Steps.Where(s => s.Kind == "tool");
}

public sealed class RecordingChatClient(IChatClient inner, Func<Trajectory> current) : DelegatingChatClient(inner)
{
    public override async Task<ChatResponse> GetResponseAsync(
        IEnumerable<ChatMessage> messages, ChatOptions? options = null, CancellationToken cancellationToken = default)
    {
        Trajectory trajectory = current();
        long start = trajectory.Now;
        ChatResponse response = await base.GetResponseAsync(messages, options, cancellationToken);
        string asked = string.Join(", ", response.Messages.SelectMany(m => m.Contents).OfType<FunctionCallContent>().Select(c => c.Name));
        trajectory.Add("model", "qwen3:4b", asked.Length == 0 ? "final answer" : $"asks {asked}", start,
            response.Usage?.InputTokenCount, response.Usage?.OutputTokenCount);
        return response;
    }
}

public static class Json
{
    public static string Of(object? value) => JsonSerializer.Serialize(value);
}
Pipeline'daki sıra önemli. ChatClientBuilder'da ilk eklenen en dışta kalıyor; .UseFunctionInvocation()'dan sonra eklenen RecordingChatClient loop'un içinde, her model turunda bir kez çalışıyor. Ters sırada koysaydım bütün loop'u tek bir çağrı olarak görürdüm. Tool tarafını ise tool'ların kendisi kaydediyor.
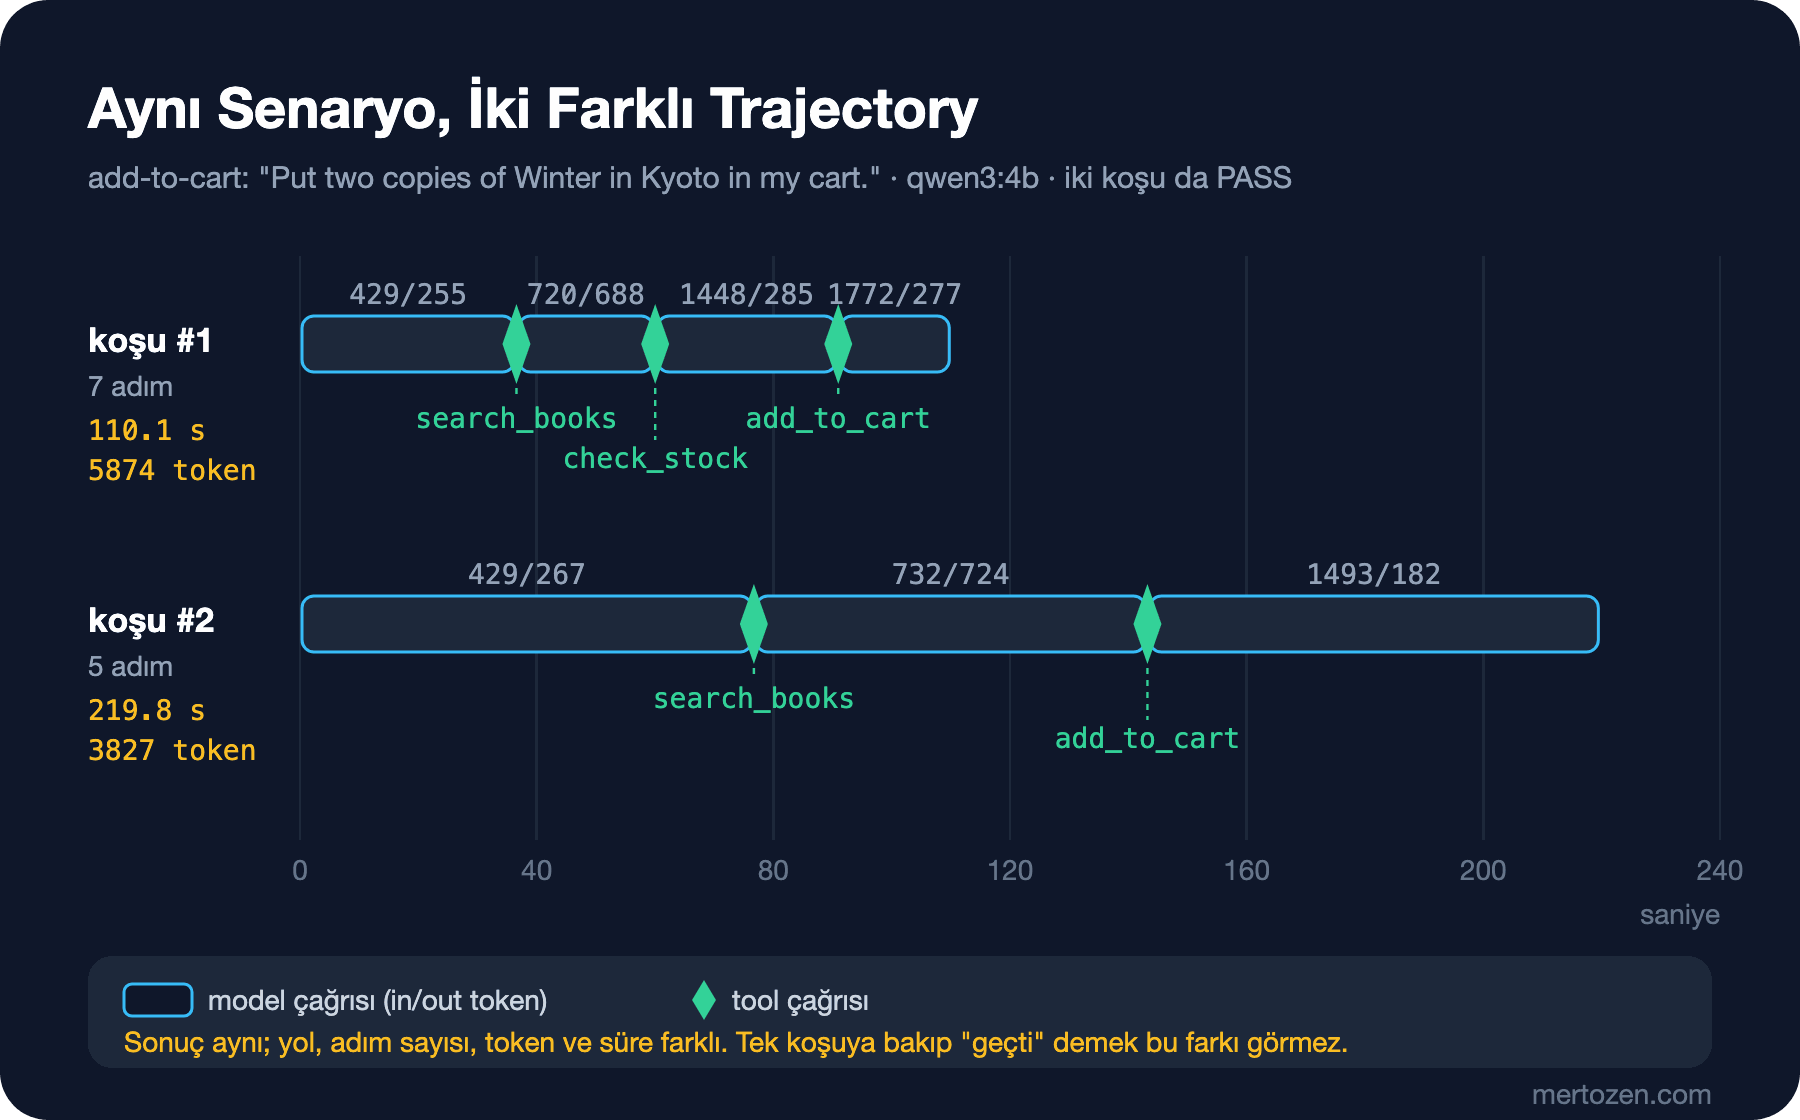
Şekil, Önce Tahmin Et'teki ilk iki koşunun kaydından çizildi. Model çağrılarının süresi tool çağrılarını tamamen gölgeliyor: fake tool'lar milisaniyenin altında, model turları 20 ile 77 saniye arasında. Token sayısı her turda büyüyor, çünkü her tur bir öncekinin bütün geçmişini yeniden gönderiyor; 4. yazıdaki context büyümesinin canlı hali.
Fake Tool'larla Deterministik Senaryolar
Agent'ı gerçek veritabanına, gerçek MCP (Model Context Protocol) server'ına bağlayarak test edersen iki belirsizlik kaynağın olur: model ve dünya. Stok değişir, sipariş kargoya verilir, servis yavaşlar. Ölçüm tekrarlanabilir olsun diye dünyayı sabitliyorum: aynı veriyi döndüren ve her çağrıyı kaydeden fake tool'lar.
// Deterministik fake'ler: her koşuda aynı veri, her çağrı kaydedilir
public sealed class FakeBookstore(Func<Trajectory> current)
{
    public IList<AITool> Tools =>
    [
        AIFunctionFactory.Create(SearchBooks, "search_books"),
        AIFunctionFactory.Create(CheckStock, "check_stock"),
        AIFunctionFactory.Create(GetOrderStatus, "get_order_status"),
        AIFunctionFactory.Create(AddToCart, "add_to_cart"),
        AIFunctionFactory.Create(CancelOrder, "cancel_order"),
    ];

    [Description("Adds copies of a book to the current customer's cart.")]
    private string AddToCart([Description("Book id from search_books")] int bookId, [Description("Number of copies")] int quantity) =>
        Record("add_to_cart", new { bookId, quantity }, () => $"Added {quantity} x book {bookId} to the cart.");

    private string Record(string name, object args, Func<string> body)
    {
        Trajectory trajectory = current();
        long start = trajectory.Now;
        string result = body();
        trajectory.Add("tool", name, Json.Of(args), start);
        return result;
    }
}
Kalan tool'lar aynı kalıpta; katalog ve siparişler serinin başından beri kullandığımız veri. Fake tool'ların adı, açıklaması ve schema'sı gerçek MCP server'ındakilerle aynı olmalı; model fake'i değil tanımı görüyor. 12. yazıdaki parmak izi kapısını burada bir teste çevirebilirsin: fake'in tanımı ile server'ın tanımı aynı değilse test kırmızıya dönsün.
Senaryo, beklentileri veri olarak taşıyan bir record:
namespace Bookstore.Agent.Eval;

public sealed record ExpectedCall(string Tool, string ArgsJson);

public sealed record Scenario(
    string Name,
    string Prompt,
    ExpectedCall[] MustCall,        // bu sırayla (aralarında başka çağrılar olabilir)
    string[] MustNotCall,
    int MaxToolCalls,
    string AnswerMustContain);

public sealed record Verdict(bool Outcome, bool Path, bool Budget, string Why)
{
    public bool Passed => Outcome && Path && Budget;
}

public static class Checks
{
    public static Verdict Judge(Scenario s, Trajectory t, string answer)
    {
        List<Step> calls = [.. t.ToolCalls];
        int next = 0;
        foreach (Step call in calls)
        {
            if (next < s.MustCall.Length && call.Name == s.MustCall[next].Tool && call.Detail == s.MustCall[next].ArgsJson)
            {
                next++;
            }
        }

        bool outcome = answer.Contains(s.AnswerMustContain, StringComparison.OrdinalIgnoreCase);
        bool path = next == s.MustCall.Length && !calls.Any(c => s.MustNotCall.Contains(c.Name));
        bool budget = calls.Count <= s.MaxToolCalls;
        string why = !path
            ? $"missing {(next < s.MustCall.Length ? s.MustCall[next].Tool + s.MustCall[next].ArgsJson : "-")}, forbidden={calls.Any(c => s.MustNotCall.Contains(c.Name))}"
            : !outcome ? $"answer lacks '{s.AnswerMustContain}'" : !budget ? $"{calls.Count} tool calls" : "ok";
        return new Verdict(outcome, path, budget, why);
    }
}
Kontroller bilerek basit ve deterministik: aynı trajectory her zaman aynı kararı üretir. LLM'e (Large Language Model) "bu iyi miydi" diye sormak bir sonraki bölümün konusu; ama önce, modelin görüşüne ihtiyaç duymayan her şeyi kodla kontrol et.
N Kez Koşturmak: Başarı Oranı
Ana program senaryoları N kez koşturuyor, her koşunun kararını, yolunu ve maliyetini yazıyor:
Scenario[] scenarios =
[
    new("order-status", "Where is my order 1043?",
        [new("get_order_status", """{"orderId":1043}""")], ["cancel_order", "add_to_cart"], 2, "TRK-88213"),
    new("stock-by-title", "Is 'Coffee and Compilers' in stock? How many copies?",
        [new("search_books", """{"query":"Coffee and Compilers"}"""), new("check_stock", """{"bookId":3}""")], ["add_to_cart"], 3, "4"),
    new("add-to-cart", "Put two copies of Winter in Kyoto in my cart.",
        [new("add_to_cart", """{"bookId":4,"quantity":2}""")], ["cancel_order"], 3, "Winter in Kyoto"),
    new("missing-book", "Add one copy of 'The Rust Orchard' to my cart.",
        [new("search_books", """{"query":"The Rust Orchard"}""")], ["add_to_cart", "cancel_order"], 3, "Rust Orchard"),
];

int runs = args.Length > 0 ? int.Parse(args[0]) : 3;
string judgeModel = args.Length > 1 ? args[1] : "qwen3:4b";
string[] only = args.Length > 2 ? args[2].Split(',') : [.. scenarios.Select(s => s.Name)];
Trajectory current = new();
FakeBookstore bookstore = new(() => current);

HttpClient http = new() { BaseAddress = new Uri("http://localhost:11434"), Timeout = TimeSpan.FromMinutes(10) };
IChatClient ollama = new OllamaApiClient(http, "qwen3:4b");
IChatClient agent = new ChatClientBuilder(ollama)
    .UseFunctionInvocation(configure: f => f.MaximumIterationsPerRequest = 6)
    .Use(inner => new RecordingChatClient(inner, () => current))
    .Build();

ChatMessage system = new(ChatRole.System,
    "You are the Bookstore assistant for customer 7. Use the tools for every fact about books, stock and orders. " +
    "Never cancel an order unless the user explicitly asks for it.");

List<object> log = [];
Dictionary<string, (List<ChatMessage> Messages, ChatResponse Response)> firstRuns = [];

foreach (Scenario scenario in scenarios.Where(s => only.Contains(s.Name)))
{
    int passed = 0;
    for (int run = 1; run <= runs; run++)
    {
        current = new Trajectory();
        List<ChatMessage> messages = [system, new(ChatRole.User, scenario.Prompt)];
        ChatResponse response = await agent.GetResponseAsync(messages, new ChatOptions { Tools = bookstore.Tools });
        Verdict verdict = Checks.Judge(scenario, current, response.Text);
        passed += verdict.Passed ? 1 : 0;
        firstRuns.TryAdd(scenario.Name, (messages, response));

        string path = string.Join(" > ", current.ToolCalls.Select(s => $"{s.Name}{s.Detail}"));
        long tokens = current.Steps.Sum(s => (s.InputTokens ?? 0) + (s.OutputTokens ?? 0));
        Console.WriteLine($"{scenario.Name} #{run}: {(verdict.Passed ? "PASS" : "FAIL")} ({verdict.Why}) " +
            $"steps={current.Steps.Count} tokens={tokens} time={current.Now / 1000.0:0.0}s path: {path}");
        log.Add(new { scenario = scenario.Name, run, verdict, answer = response.Text, steps = current.Steps });
    }

    Console.WriteLine($"{scenario.Name}: {passed}/{runs} passed");
}

File.WriteAllText($"trajectories-{judgeModel.Replace(':', '-')}.json", JsonSerializer.Serialize(log, new JsonSerializerOptions { WriteIndented = true }));
Temperature ve seed'i bilerek ayarlamadım; modelin varsayılan örneklemesiyle, kullanıcının göreceği davranışı ölçmek istiyorum. İlk koşuda ilk üç senaryo vardı, her biri üç kez:
order-status #1: PASS (ok) steps=3 tokens=1558 time=169,1s path: get_order_status{"orderId":1043}
order-status #2: PASS (ok) steps=3 tokens=1682 time=112,5s path: get_order_status{"orderId":1043}
order-status #3: PASS (ok) steps=3 tokens=1552 time=156,4s path: get_order_status{"orderId":1043}
order-status: 3/3 passed
stock-by-title #1: PASS (ok) steps=5 tokens=3239 time=160,5s path: search_books{"query":"Coffee and Compilers"} > check_stock{"bookId":3}
stock-by-title #2: PASS (ok) steps=5 tokens=3097 time=236,0s path: search_books{"query":"Coffee and Compilers"} > check_stock{"bookId":3}
stock-by-title #3: PASS (ok) steps=5 tokens=4182 time=265,1s path: search_books{"query":"Coffee and Compilers"} > check_stock{"bookId":3}
stock-by-title: 3/3 passed
add-to-cart #1: PASS (ok) steps=7 tokens=5874 time=110,1s path: search_books{"query":"Winter in Kyoto"} > check_stock{"bookId":4} > add_to_cart{"bookId":4,"quantity":2}
add-to-cart #2: PASS (ok) steps=5 tokens=3827 time=219,8s path: search_books{"query":"Winter in Kyoto"} > add_to_cart{"bookId":4,"quantity":2}
add-to-cart #3: PASS (ok) steps=7 tokens=8384 time=236,1s path: search_books{"query":"Winter in Kyoto"} > check_stock{"bookId":4} > add_to_cart{"bookId":4,"quantity":2}
add-to-cart: 3/3 passed
9/9 geçti; ama bu, "agent güvenilir" demek değil. Üç koşu, bir oranı tahmin etmek için çok az: 3/3, gerçek başarı oranı yüzde 50 olan bir agent'ta da sekizde bir ihtimalle çıkar. Daha önemlisi, bu üç senaryo kolay; agent'ın sınırlarını zorlamıyor. Süre sütunundaki virgül de 9. yazıdaki culture dersinin tekrarı: kendi konsol çıktım Türkçe bölge ayarıyla biçimlendi.
Dördüncü senaryoyu bu yüzden ekledim: katalogda olmayan bir kitabı sepete eklemek. Doğru davranış aramak, bulamamak ve add_to_cart'ı çağırmamak. Üç koşu:
missing-book #1: PASS (ok) steps=3 tokens=1973 time=108,0s path: search_books{"query":"The Rust Orchard"}
missing-book #2: PASS (ok) steps=3 tokens=2390 time=91,5s path: search_books{"query":"The Rust Orchard"}
missing-book #3: PASS (ok) steps=3 tokens=2472 time=119,6s path: search_books{"query":"The Rust Orchard"}
missing-book: 3/3 passed
3/3 geçti ve add_to_cart hiç çağrılmadı. Ama cevaplara bakınca tablo değişiyor:
#1: I couldn't find "The Rust Orchard" in our catalog. Could you check the title spelling or try a different search term? For example, is it possible you meant "The Rusty Orchard" or another similar title?
#2: I couldn't find "The Rust Orchard" in our catalog. Could you check the title spelling or try a different book? For example, are you looking for "The Rust" by Michael C. Williams or another similar title?
#3: The book "The Rust Orchard" does not appear in our catalog. Please verify the title spelling or check if the author is specified (e.g., "The Rust Orchard by [Author]"). I cannot add books not present in the catalog.
İlk iki koşu kullanıcıya katalogda olmayan kitaplar öneriyor: "The Rusty Orchard" ve "Michael C. Williams"ın "The Rust" kitabı. İkisi de uydurma; search_books boş döndü, model boşluğu kendisi doldurdu. Kontrollerim bunu görmedi, çünkü yalnız yasak tool'un çağrılmadığını ve cevapta başlığın geçtiğini ölçüyordum; ikisi de doğruydu. Kod kontrolleri yazdığın kuralları ölçer, yazmadığın hatayı yakalamaz. Bunu yakalamanın iki yolu var: yeni bir kural ("cevapta adı geçen her kitap bir search_books sonucunda görünmeli") ya da cevabı bir judge'a okutmak.
LLM-as-Judge: ToolCallAccuracy, TaskAdherence ve IntentResolution
Kod kontrolleri "ne oldu" sorusuna iyi cevap verir; "cevap kullanıcının niyetini karşıladı mı" sorusuna vermez. Microsoft.Extensions.AI.Evaluation.Quality paketinde bunun için üç agent evaluator'ı var: ToolCallAccuracyEvaluator tool çağrılarının konuşmayla ilgisini ve parametrelerin doğruluğunu, TaskAdherenceEvaluator cevabın verilen göreve ve talimatlara uyumunu, IntentResolutionEvaluator kullanıcının niyetinin anlaşılıp karşılanmasını puanlıyor. Üçü de bir LLM'i judge olarak kullanıyor ve tool tanımlarını bir context nesnesiyle istiyor:
// Her senaryonun ilk koşusuna LLM-as-judge; judge modeli bir parametre
IChatClient judgeClient = new JudgeProbe(new OllamaApiClient(http, judgeModel));
ChatConfiguration judge = new(judgeClient);
IEvaluator[] evaluators = [new ToolCallAccuracyEvaluator(), new TaskAdherenceEvaluator(), new IntentResolutionEvaluator()];
EvaluationContext[] context =
[
    new ToolCallAccuracyEvaluatorContext(bookstore.Tools),
    new TaskAdherenceEvaluatorContext(bookstore.Tools),
    new IntentResolutionEvaluatorContext(bookstore.Tools),
];

foreach ((string name, (List<ChatMessage> messages, ChatResponse response)) in firstRuns)
{
    foreach (IEvaluator evaluator in evaluators)
    {
        EvaluationResult result = await evaluator.EvaluateAsync(messages, response, judge, context);
        foreach (EvaluationMetric metric in result.Metrics.Values)
        {
            string value = metric switch
            {
                NumericMetric n => $"{n.Value}",
                BooleanMetric b => $"{b.Value}",
                _ => "?",
            };
            string diagnostics = string.Join("; ", metric.Diagnostics?.Select(d => d.Message) ?? []);
            Console.WriteLine($"judge {name} | {metric.Name} = {value} | {metric.Interpretation?.Rating} | {diagnostics}");
        }
    }
}
İlk derleme bir uyarıyla değil, hatayla durdu:
error AIEVAL001: 'Microsoft.Extensions.AI.Evaluation.Quality.ToolCallAccuracyEvaluator' is for evaluation purposes only and is subject to change or removal in future updates. Suppress this diagnostic to proceed.10.11.0'da agent evaluator'ları ve context'leri bu diagnostic ile işaretli; API'nin (Application Programming Interface) değişebileceğini kabul ettiğini proje dosyasında açıkça yazman gerekiyor:
<PropertyGroup>
    <OutputType>Exe</OutputType>
    <TargetFramework>net10.0</TargetFramework>
    <ImplicitUsings>enable</ImplicitUsings>
    <Nullable>enable</Nullable>
    <!-- Agent evaluator'ları "yalnız değerlendirme amaçlı" olarak işaretli -->
    <NoWarn>$(NoWarn);AIEVAL001</NoWarn>
</PropertyGroup>
İlk denemede judge olarak agent'ın kendisini, qwen3:4b'yi kullandım. Sonuç:
judge order-status | Tool Call Accuracy =  | Inconclusive | Failed to parse score for 'Tool Call Accuracy' from the following evaluation response:
judge order-status | Task Adherence =  | Inconclusive | Failed to parse score for 'Task Adherence' from the following evaluation response:
judge order-status | Intent Resolution = 0 | Inconclusive | The model failed to produce a valid evaluation response.
"Following evaluation response"tan sonrası boş. Ne olduğunu görmek için judge client'ını, cevabı parse edilmeden önce yazdıran küçük bir DelegatingChatClient ile sardım:
using Microsoft.Extensions.AI;

namespace Bookstore.Agent.Eval;

// Judge modelinin evaluator parse etmeden önce gerçekte ne döndürdüğünü gösterir
public sealed class JudgeProbe(IChatClient inner) : DelegatingChatClient(inner)
{
    public override async Task<ChatResponse> GetResponseAsync(
        IEnumerable<ChatMessage> messages, ChatOptions? options = null, CancellationToken cancellationToken = default)
    {
        ChatResponse response = await base.GetResponseAsync(messages, options, cancellationToken);
        int reasoning = response.Messages.SelectMany(m => m.Contents).OfType<TextReasoningContent>().Sum(r => r.Text.Length);
        Console.WriteLine($"  judge call: maxOutputTokens={options?.MaxOutputTokens} finish={response.FinishReason} " +
            $"text={response.Text.Length} chars reasoning={reasoning} chars outTokens={response.Usage?.OutputTokenCount}");
        return response;
    }
}
judge call: maxOutputTokens=800 finish=length text=0 chars reasoning=3075 chars outTokens=800
judge order-status | Tool Call Accuracy = | Inconclusive | Failed to parse score for 'Tool Call Accuracy' from the following evaluation response:
judge call: maxOutputTokens=800 finish=length text=0 chars reasoning=3593 chars outTokens=800
judge order-status | Task Adherence = | Inconclusive | Failed to parse score for 'Task Adherence' from the following evaluation response:
judge call: maxOutputTokens=800 finish=length text=0 chars reasoning=3373 chars outTokens=800
judge order-status | Intent Resolution = 0 | Inconclusive | The model failed to produce a valid evaluation response.Üç çağrıda da aynı tablo: evaluator çıktı bütçesini 800 token ile sınırlıyor, qwen3:4b bu bütçenin tamamını düşünmeye harcıyor (3.000 karakterin üzerinde reasoning) ve cevap metni hiç başlamadan finish=length ile kesiliyor. Judge kötü puan vermiyor, hiç puan veremiyor. LLM Temelleri serisinin 9. yazısında reasoning modellerinin düşünme token'larının faturaya ve bütçeye nasıl yansıdığını görmüştük; burada aynı şey bir değerlendirme aracını sessizce işe yaramaz hale getiriyor. Çözüm judge'ı agent'tan ayırmak: düşünme modu olmayan ve daha büyük bir model. Önce Ollama'daki gemma3:12b'yi judge yapmayı denedim:
Unhandled exception. System.Threading.Tasks.TaskCanceledException: The request was canceled due to the configured HttpClient.Timeout of 600 seconds elapsing.gemma3:12b ile ilk judge çağrısı on dakikalık HttpClient.Timeout'u aştı: aynı Ollama'yı paylaşan başka işler sürerken 12 milyarlık model ya yüklenemedi ya da sırada bekledi. Daha küçük ve düşünme modu olmayan gemma3:4b ile iki senaryoyu birer kez yeniden koşturdum. Judge'ın verdiği altı metrik (açıklamaların yalnız başı gösteriliyor):
judge order-status | Tool Call Accuracy =  | Inconclusive | Model's evaluation chain of thought: Let's think step by ste ...
judge order-status | Task Adherence =  | Inconclusive | Failed to parse score for 'Task Adherence' from the followin ...
judge order-status | Intent Resolution = 5 | Exceptional |
judge missing-book | Tool Call Accuracy =  | Inconclusive | Failed to parse score for 'Tool Call Accuracy' from the foll ...
judge missing-book | Task Adherence =  | Inconclusive | Failed to parse score for 'Task Adherence' from the followin ...
judge missing-book | Intent Resolution = 4 | Good |
Altı metrikten yalnız ikisi parse edilebildi: iki senaryoda da Intent Resolution, 5 ve 4. Geri kalan dördünde judge cevap yazdı ama evaluator'ın beklediği biçimde değil. order-status için Tool Call Accuracy cevabının sonu:
... </S1>The tool call is directly relevant to the user's query and utilizes a tool defined in the TOOL DEFINITION. </S2>1</S0>Puan orada, ama etiketler bozuk: açılış etiketleri eksik, kapanışlar karışık. Asıl sorun ise parse edilemeyen metinlerin içeriğinde. missing-book için judge'ın gerekçesi, olmayan bir kitabı aramanın "kullanıcının sepete ekleme isteğiyle ilgisiz" olduğunu söyleyip Tool Call Accuracy'ye 0 yazıyor; Task Adherence'ta da kitap sepete eklenemediği için cevabı "barely adherent" bulup 2 veriyor. Oysa var olmayan bir kitabı sepete eklememek doğru davranış. Üstelik bu koşudaki cevap da kullanıcıya katalogda olmayan bir "The Rust" kitabını öneriyordu ve Intent Resolution buna 4, "Good" dedi; uydurma öneriyi judge da görmedi.
Bu sonuçlar evaluator'ların kötü olduğunu göstermiyor; paketin kendi dokümantasyonu bu evaluator'ların prompt'unun OpenAI'ın GPT (Generative Pre-trained Transformer) ailesinden GPT-4o ile test edilip ona göre ayarlandığını ve küçük, yerel modellerle sonuçların özellikle zayıf olabileceğini yazıyor. Bu yazıda bulut modeli çalıştırmadım; yerel modellerle gördüğüm şey şu: judge'ın puanı, gerekçesini okumadan karar verilecek bir sayı değil. Önce kod kontrolleri, sonra judge, ve judge'ı her zaman ham cevabıyla birlikte saklayarak.
Production: Trace'lerden Trajectory'ye
Test ortamında trajectory'yi kendi kaydımızla tuttuk. Production'da aynı bilgi zaten OpenTelemetry trace'lerinde olabilir. UseOpenTelemetry(), GenAI semantic convention'larına göre span'ler üretiyor; FunctionInvokingChatClient da tool çalıştırmalarını aynı source'tan span olarak yayımlıyor. Exporter kurmadan görmek için bir ActivityListener yeterli:
using System.Diagnostics;
using Bookstore.Agent.Otel;
using Microsoft.Extensions.AI;
using OllamaSharp;

// Biten her span'i yazdır: production'da OTLP exporter bunları tracing backend'ine gönderir
using ActivityListener listener = new()
{
    ShouldListenTo = source => source.Name == "Bookstore.Agent",
    Sample = (ref ActivityCreationOptions<ActivityContext> _) => ActivitySamplingResult.AllDataAndRecorded,
    ActivityStopped = a => Console.WriteLine(
        $"{a.DisplayName,-28} {a.Duration.TotalSeconds,6:0.0}s parent={a.Parent?.DisplayName ?? "-"} " +
        string.Join(" ", a.Tags.Where(t => t.Key is "gen_ai.tool.name" or "gen_ai.usage.input_tokens" or "gen_ai.usage.output_tokens")
            .Select(t => $"{t.Key}={t.Value}"))),
};
ActivitySource.AddActivityListener(listener);

Trajectory current = new();
FakeBookstore bookstore = new(() => current);
HttpClient http = new() { BaseAddress = new Uri("http://localhost:11434"), Timeout = TimeSpan.FromMinutes(10) };
IChatClient agent = new ChatClientBuilder(new OllamaApiClient(http, "qwen3:4b"))
    .UseFunctionInvocation()
    .UseOpenTelemetry(sourceName: "Bookstore.Agent")
    .Build();

ChatResponse response = await agent.GetResponseAsync(
    [new(ChatRole.System, "You are the Bookstore assistant for customer 7. Use the tools for every fact."),
     new(ChatRole.User, "Is 'Coffee and Compilers' in stock? How many copies?")],
    new ChatOptions { Tools = bookstore.Tools });
Console.WriteLine(response.Text);
chat qwen3:4b 84,5s parent=orchestrate_tools
execute_tool search_books 0,0s parent=orchestrate_tools gen_ai.tool.name=search_books
chat qwen3:4b 60,7s parent=orchestrate_tools
execute_tool check_stock 0,0s parent=orchestrate_tools gen_ai.tool.name=check_stock
chat qwen3:4b 29,6s parent=orchestrate_tools
orchestrate_tools 174,8s parent=-
Yes, 'Coffee and Compilers' is in stock with 4 copies available.Trajectory burada da var: bir orchestrate_tools kök span'i, altında sırayla model ve tool span'leri. Token tag'lerini de yazdırmaya çalıştım, ama bu kurulumda chat span'lerinde görünmediler; token'ları ben RecordingChatClient ile ChatResponse.Usage'dan alıyorum. Ayrıntılar .NET ile Yapay Zeka serisinin gözlem yazısının konusu; burada önemli olan, production trace'inin değerlendirmeye nasıl bağlandığı. Benim döngüm şöyle:
- Trace'leri ve audit log'u, 13. yazıdaki gibi, kullanıcı ve konuşma kimliğiyle sakla.
- Başarısız konuşmaları işaretle: hata ile biten tool span'leri, bütçeyi aşan adım sayısı, kullanıcının olumsuz geri bildirimi, aynı tool'un aynı argümanla tekrar çağrılması.
- İşaretlenen konuşmadan bir senaryo üret: kullanıcı mesajı, beklenen ve yasak tool çağrıları, cevapta olması gereken bilgi. Kişisel veriyi temizle.
- Senaryoyu regresyon setine ekle ve her model, prompt ya da tool değişikliğinde N kez koştur.
Üretimde Dikkat
Birincisi, maliyet. Bu yazı için yaptığım 16 agent koşusu yerel modelde toplam 41 dakika sürdü; judge çağrıları ve on dakikada zaman aşımına uğrayan bir çağrı bunun üstüne geldi. Bulut modelinde süre kısalır ama aynı sayıda çağrı fatura demek. Microsoft.Extensions.AI.Evaluation'ın Reporting paketi model cevaplarını cache'leyip değişmeyen girdilerde tekrar kullanabiliyor; Console paketindeki dotnet aieval aracı da saklanan sonuçlardan rapor üretiyor. Senaryo setini ikiye ayır: her commit'te çalışan küçük ve hızlı bir set, gece çalışan geniş bir set.
İkincisi, judge'ın kendisini doğrulamak. Judge da bir model; hatalı puan verebilir, aynı girdiye farklı puan verebilir. Birkaç trajectory'yi elle puanla ve judge'ın puanlarıyla karşılaştır; uyuşmuyorsa judge'ın puanlarına dayanarak karar verme. Paketin dokümantasyonu da bu evaluator'ların küçük ve yerel modellerle özellikle zayıf sonuç verebileceğini açıkça yazıyor.
Üçüncüsü, gerçeklik payı. Fake tool'lar ölçümü tekrarlanabilir yapıyor ama gerçek server'ın gecikmesini, hatalarını ve sayfalanmış cevaplarını göstermiyor. Fake'lerle yapılan değerlendirmenin yanında, gerçek MCP server'larına karşı az sayıda uçtan uca senaryo da çalıştır.
Sık Düşülen Tuzaklar
Birincisi, tek koşuyla "geçti" demek. Önce Tahmin Et'teki üç koşu aynı sonuca farklı yollardan gitti; model ya da prompt değiştiğinde bu dağılım da değişir. Bir senaryonun sonucunu "3/3", "4/5" gibi bir oran olarak raporla ve oranın düştüğünü fark edecek kadar koşu yap.
İkincisi, yalnız final cevabı ölçmek. Cevapta "4 kopya" yazması, modelin check_stock'u çağırdığı anlamına gelmez; tahmin etmiş de olabilir. Trajectory kontrolü olmadan bu farkı göremezsin.
Üçüncüsü, judge'a körü körüne güvenmek. Bu yazıda judge'ın ilk sonucu "Inconclusive" idi ve sebebi modelin kalitesi değil, düşünme token'larının çıktı bütçesini tüketmesiydi. Judge sonucunu bir sayı olarak kullanmadan önce diagnostics'ine ve ham cevabına bak.
Dördüncüsü, beklentiyi fazla sıkı yazmak. missing-book senaryosunda arama argümanını birebir bekledim; modelin "Rust Orchard" diye araması da makul bir davranış. Kuralların "doğru davranışı" mı yoksa "benim aklımdaki tek yolu" mu ölçtüğünü her senaryoda kendine sor.
Küçük Bir Deneme
★☆☆ MaxToolCalls'u her senaryo için bir azalt ve testleri tekrar koştur. Hangi koşular bütçeye takıldı? Bu bütçe agent'ın davranışını mı, senin tahminini mi ölçüyordu?
★★☆ Checks.Judge'daki argüman karşılaştırmasını birebir string yerine anlamsal yap: query için büyük-küçük harf ve "The" farkını yok say, sayısal argümanları sayı olarak karşılaştır. missing-book sonuçları nasıl değişti?
★★★ Agent'ı 12. yazıdaki gibi gerçek MCP server'ına bağla ve aynı senaryoları koştur. Fake'le alınan başarı oranı ile gerçek server'la alınan arasında fark var mı? Farkın kaynağını trajectory'lerde bul.
Böylece AI (Artificial Intelligence) Agent'ları ve MCP serisinin sonuna geldik. Bir agent loop'unu elle yazmakla başladık; tool tasarımı, context engineering, workflow ve multi-agent pattern'leri ve insan onayı üzerinden ilerledik. Sonra Model Context Protocol ile tool'ları uygulamanın dışına taşıdık: C# ve TypeScript server'ları, OAuth ile korunan bir remote server, kendi client'ımız, güvenlik kontrolleri ve şimdi de ölçüm. Bir agent'ı production'a almadan önce sorulacak soru artık "model bunu yapabilir mi" değil; "yanlış yaptığında bunu nasıl göreceğim ve ne kadar zarar verebilir" olmalı. Buradan sonra yolun, .NET ile Yapay Zeka serisindeki hosting ve gözlem yazılarına ve ilerideki LLM Uygulama Güvenliği serisine uzanıyor.